Постоянна тема: Новини за целия AI сектор: модели, програмиране, агенти, роботика, научни изследвания, хардуер и практически приложения.

Qwen4-Max Preview отваря временен достъп, но не е окончателен старт на Qwen4

Директният API достъп е през Token Plan, с прозорец до края на 25 ноември по UTC+8. Контекстът и изходният бюджет са различни; публикуваните възможности не заменят независими оценки.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
qwen4-max-preview-access-lifecycle-2026-eaf4c2b1defcf3e4.jpg


Qwen4-Max е достъпен като временен preview, но това не е окончателен старт на цялото семейство Qwen4. На 11 ноември 2026 г. Qwen обявява ранния достъп, отразен от японското технологично издание PC Watch с вграден оригинален пост. За разработчиците съществената новина е възможността да изпробват конкретна версия при ограничен жизнен цикъл.

Каналите за достъп не са еднакви

PC Watch описва достъп през приложенията на Qwen, QwenWork, Qoder и Token Plan. Тези продуктови канали не са една обща абонаментна услуга. По-специално, изискването за Token Plan в официалната документация се отнася до директния API достъп; то не означава, че всяка потребителска употреба през приложение изисква същия договор.

Страницата Token Plan Individual описва абонамент за разработчици с общ баланс от кредити за модели и вградени инструменти. Това е различен механизъм от свободно плащане за отделни API заявки. Промоциите могат да се променят, затова от временни намаления не извеждаме постоянна бъдеща цена за Qwen4.

Какво е записано в спецификацията

Официалният идентификатор е `qwen4-max-preview`. Документацията посочва контекст от един милион токена и максимален изход 393 216 токена, споделен между разсъждението и крайния отговор. Това са различни бюджети: дългият контекст не означава толкова голям генериран отговор, а разсъждението използва част от изходния лимит.

Посочени са текстови, образни и видео входове, извикване на инструменти и структурирани резултати. Това описва интерфейс и заявени възможности. Не измерва автоматично колко успешно моделът ще реши конкретна задача в дадена организация.

Временният прозорец е част от продукта

Официалните условия определят периода от 10:00 на 11 ноември до 24:00 на 25 ноември 2026 г. по UTC+8. Запазваме оригиналната часова зона и означението за края на деня. След този preview моделът трябва да бъде изведен от употреба; според документацията самата версия няма да се променя в рамките на прозореца.

Това дава основа за ограничен тест, но изисква план за след него. Наличността на временен идентификатор не е обещание за непрекъснат производствен достъп, нито дата за окончателната версия на цялото семейство.

Редакционен прочит: какъв тест би бил полезен

За екип, който оценява модел, разумната отправна точка е малък набор реални задачи с предварително описан успешен резултат. При работа с инструменти трябва да се разграничават избраният инструмент, подадените параметри и действителното изпълнение. Коректно изглеждащата заявка и правилният краен резултат са различни проверки.

Дългият контекст също заслужава задача, а не само демонстрация с много текст. Например оценката може да проследи дали отговорът използва правилния документ, различава актуална от стара информация и запазва важните ограничения. Това са предложени критерии; SIExpo не е изпълнявал собствен бенчмарк на preview версията.

За сравнимост е полезно да се запазят идентификаторът, настройките, входовете и моментът на теста. Когато прозорецът приключи, резултатите ще останат описание на тази конкретна версия. Те не трябва автоматично да се прехвърлят към следващ модел със сходно име.

Това е особено важно, когато се оценява многостъпково приложение, а не отделен отговор. Определенията на инструментите и проверките за успех трябва да останат достатъчно устойчиви, за да се разбира какво е променено между опитите. Иначе промяна в приложението може да се обърка с промяна във възможностите на модела.

Какво още не следва от обявата

Предоставеният достъп не е публикация на тегла или лиценз за отворен модел. От него не извеждаме брой параметри, превъзходство в независима класация или окончателен продуктов график. Рекламните твърдения за по-силни програмни и агентни способности остават твърдения на разработчика.

Потвърденото събитие е начало на ограничен тестов достъп. Стойността му ще се изяснява чрез конкретни резултати и последващи официални условия, а не чрез отъждествяване на preview с окончателен старт.

Източници: PC Watch — November 11 announcement and embedded Qwen post, QwenCloud — Qwen4-Max-Preview specification and lifecycle, QwenCloud — Token Plan Individual terms and credits.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-12T17:35:22.913550+00:00.

Източници
PC Watch — November 11 announcement and embedded Qwen post — 2026-11-11
QwenCloud — Qwen4-Max-Preview specification and lifecycle
QwenCloud — Token Plan Individual terms and credits

Статия в SIExpo.bg: https://siexpo.bg/article/qwen4-max-preview-access-lifecycle-2026
 
Agile Robots набра 500 млн. долара за разрастване на индустриалната роботика

SoftBank води Series F при обявена оценка 8,5 млрд. долара. Производственият капацитет и инсталираните роботизирани решения са различни показатели от доставените хуманоиди.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

agile-robots-seriesf-industrial-capacity-limits-2026-9aae8b66fc730d6e.jpg


Agile Robots обяви Series F за 500 млн. долара при оценка 8,5 млрд. долара. Кръгът е воден от SoftBank Group, с участие на NVIDIA, Hitachi Group и T.Capital. Компанията свързва средствата с разрастване в САЩ, други пазари и допълнителен производствен капацитет. Това е новина за финансиране на физически AI, а не доказателство, че универсалните роботи вече са решили всички заводски задачи.

Датите изискват уточнение

Официалната страница показва дата 10 ноември 2026 г. в заглавната си част, а самото съобщение започва с място и дата Мюнхен, 12 ноември. Запазваме това разминаване, вместо да заменяме едната дата с удобна обща дата. DPA публикува собствен материал за финансирането на 12 ноември.

В този материал агенцията описва завод край Мюнхен с обявен капацитет до 10 000 хуманоидни робота годишно. Това е капацитет според компанията, а не потвърден брой произведени или доставени машини. И по-широкият портфейл от над 20 000 инсталирани роботизирани решения не трябва да се превръща в твърдение за толкова внедрени хуманоиди.

Какво стои зад понятието „физически AI“

По-ранна продуктова публикация от 21 октомври помага да се види изследователската посока. Agile ONE SN е компактна платформа за разработчици с предварително подготвен NVIDIA Isaac GR00T софтуер. Описаният работен процес включва демонстрационни данни, симулация, обучение и проверка в реалната среда. Посочената наличност е началото на 2027 г.; октомврийската обява не се представя тук като нова доставка през ноември.

Друг контекст дава партньорството с Hitachi, обявено на 29 септември. То свързва роботите и софтуера на Agile Robots с промишлената интеграция и edge AI технологиите на Hitachi. Фокусът е върху задачи с вариации в условията, при които фиксирана последователност от движения не е достатъчна. По-широката координация на машини и хора е описана като амбиция, а не като вече измерен общ резултат.

Редакционен прочит: от демонстрация до повтаряем процес

За промишлен клиент показването на успешно движение е само една част от оценката. Следват въпросите дали то се повтаря при различни детайли, как се откриват неуспехите и как производствената линия продължава работа при нужда от намеса. Дори добре изпълнена демонстрация не определя сама тези условия.

Затова при бъдещи внедрявания има смисъл да се проследяват конкретна задача, продължителност на наблюдението и честота на човешката помощ. Трябва да е ясно и какво се брои за успех: преместване на един предмет, завършен цикъл или устойчив поток през цял работен период. Това са редакционни критерии за оценка, а не отчет от тест на SIExpo в завода.

Промяната на продукта също е практически въпрос. Робот, който се справя с една подредба, може да има нужда от нови данни или настройка за друга. Времето за такава промяна и начинът за повторно валидиране са важни за стойността му като производствен инструмент. Обещанието за гъвкавост трябва да се разглежда заедно с доказателствата за конкретната операция.

Полезният отчет за внедряване би направил тези граници видими, вместо да ги скрива зад общ процент на успех. Той би отделил и контролирания тест от обичайната производствена работа. Така читателят може по-добре да прецени дали описаното подобрение е приложимо в неговите условия.

Какво променя новият капитал

Финансирането може да подкрепи инженерни екипи, производство и обслужване на повече пазари. То не превръща обявената годишна мощност в автоматично реализирани продажби и не доказва производителност на всяка машина от портфолиото.

Agile Robots е значим участник именно защото съчетава различни видове роботи, софтуер и индустриални партньорства. Следващият важен въпрос е как тази комбинация се представя в проследими внедрявания. За читателя разграничението между набран капитал, производствен капацитет и действителна работа на терен е по-полезно от едно общо впечатляващо число.

Източници: Agile Robots — Series F release; header November 10, dateline November 12, Agile Robots — earlier Agile ONE SN research platform, Agile Robots — earlier Hitachi manufacturing partnership, DPA via Yahoo — funding report and attributed factory capacity.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-12T17:35:22.913550+00:00.

Източници
Agile Robots — Series F release; header November 10, dateline November 12 — 2026-11-10
Agile Robots — earlier Agile ONE SN research platform — 2026-10-21
Agile Robots — earlier Hitachi manufacturing partnership — 2026-09-29
DPA via Yahoo — funding report and attributed factory capacity — 2026-11-12

Статия в SIExpo.bg: https://siexpo.bg/article/agile-robots-seriesf-industrial-capacity-limits-2026
 
Fractile получава нов капитал за AI чипове: паметта е в центъра на проекта

Британското правителство потвърждава участие в кръг над 500 млн. паунда. Инвеститорите описват архитектура за бърз inference, но финансирането не доказва производителност на готов продукт.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

fractile-financing-memory-inference-hardware-2026-892f401fb623f1cf.jpg


Fractile получава ново финансиране за разработването на специализиран AI хардуер, а британската държава се включва сред инвеститорите. Съобщение на правителството от 11 ноември 2026 г. потвърждава участието на Sovereign AI Venture Fund и British Business Bank в кръг над 500 млн. паунда. Новината е за осигурен капитал за развитие, а не за вече доказано превъзходство на произведен чип.

Какво означават финансовите числа

Reuters съобщава през Euronext, че компанията е набрала 720 млн. долара в Series C, воден от Thrive Capital, Founders Fund, Lightspeed и Redpoint. Размерът е посочен от Fractile пред агенцията. Оценката от 7 млрд. долара е приписана на източник, участващ в сделката. Тя описва стойността на дружеството при финансирането, а не пари, които то получава допълнително към кръга.

Държавното участие не означава, че целият кръг е платен от бюджета. Правителственото съобщение поставя инвестицията в политика за запазване на технологични способности и икономическа стойност във Великобритания. То не дава основание да се изчислява индивидуалният публичен принос чрез изваждане на предполагаеми частни инвестиции.

Защо проектът започва от паметта

В своята инвестиционна теза CapitalG разглежда две отделни ограничения: колко данни могат да се държат близо до изчисленията и колко бързо могат да бъдат прочетени. Описаната архитектура приближава паметта до изчислителната логика чрез вертикално подреждане. Целта е съчетание от капацитет и пропускателна способност за големи модели и дълъг контекст.

Това е техническата теза на инвеститор с финансов интерес в успеха на Fractile. Неговите сравнения с други архитектури и очакванията за ускорение не са независим сравнителен тест на готов продукт.

Redpoint поставя друг акцент: компанията разработва цял стек, от схемите на чипа до софтуера за обслужване на inference. Инвеститорът свързва този подход с продължителни агентни задачи, при които моделът многократно работи с голям контекст. Това обяснява избрания пазар, но не доказва предварително резултата за всеки модел или приложение.

Редакционен прочит: скоростта на чипа и времето на задачата

За потребителя на AI агент крайният показател е кога полезната работа е приключила. По-бързото генериране може да намали част от чакането, но задачата може да включва и търсене, изпълнение на код, външни услуги и проверка на резултата. Следователно ускорение на един компонент не бива да се представя като същото ускорение на целия работен процес.

Полезна бъдеща оценка би сравнявала конкретни натоварвания при еднакви условия. Трябва да се разграничат времето до първи отговор, скоростта на последващото генериране и общият обем обслужени заявки. Към тях се добавят размерът на модела, използваната точност, дължината на контекста и броят едновременни потребители. Това са предложени критерии за прочит на бъдещи тестове, а не измервания, извършени от SIExpo.

Софтуерната съвместимост също има значение. Дори обещаващ хардуерен резултат не казва сам по себе си колко работа ще изисква пренасянето на реално приложение. За екип, който вече обслужва потребители, въпросът е и дали новият компонент може да се наблюдава, обновява и поддържа при предвидими условия.

Това разграничение обяснява и защо финансирането и техническите доказателства трябва да се оценяват отделно. Инвеститорите могат да подкрепят амбициозен инженерен подход преди съществуването на производствена система. За клиента са нужни данни за конкретната система, която действително може да получи и използва.

Какво предстои да се докаже

Reuters поставя първия търговски чип в плановете за следващата година — 2027 г. Това е бъдещ график, а не наличност днес. Финансирането дава ресурс да се продължи разработката; то не удостоверява цена, енергийна ефективност или капацитет на доставките.

Значението на историята е в мащаба на подкрепата за алтернативна inference архитектура и в участието на публични инвеститори. Техническата оценка трябва да остане отделна: тя ще зависи от достъпни системи, възпроизводими измервания и действителни внедрявания.

Източници: UK Government — public participation in Fractile financing, CapitalG — memory bandwidth and capacity investment thesis, Redpoint — full-stack inference hardware investment thesis, Reuters via Euronext — financing amount and attributed valuation.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-12T17:35:22.913550+00:00.

Източници
UK Government — public participation in Fractile financing — 2026-11-11
CapitalG — memory bandwidth and capacity investment thesis — 2026-11-11
Redpoint — full-stack inference hardware investment thesis — 2026-11-11
Reuters via Euronext — financing amount and attributed valuation — 2026-11-11

Статия в SIExpo.bg: https://siexpo.bg/article/fractile-financing-memory-inference-hardware-2026
 
AGIBOT добавя жива демонстрация на RoboBeats: как роботът избира какво да запомни

Промяната от 10 ноември добавя обработка кадър по кадър и собствени условия. LIFE е по-стар изследователски проект; демонстрацията не доказва непрекъснато автономно учене или готов домашен робот.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

agibot-life-robobeats-live-stream-update-2026-048d405fd237c89e.jpg


AGIBOT отбелязва в публичното хранилище LIFE обновяване на RoboBeats от 10 ноември 2026 г.: обработка кадър по кадър с повторно използване на cache, собствени условия и жива демонстрация за камера или видео. Това е конкретният нов повод. Теглата и кодът са обявени по-рано, на 3 ноември, а научната работа е от 30 октомври. По-късна медийна публикация не премества тези дати и не означава ново пускане на целия проект.

Наблюдение, което подбира

RoboBeats е малък визуално-езиков gate, който оценява поток с един кадър в секунда. Документацията разграничава откриването на събития от проследяването на зададени условия. При демонстрацията кадрите се изпращат към сървъра, който операторът стартира, а резултатът се показва в движение. „Локална демонстрация“ затова изисква да се знае къде се намира този сървър; тя не означава автоматично, че всяко изчисление е в браузъра.

В по-широката научна архитектура избраните наблюдения влизат в Plastic Memory, която запазва изображения и структурирани сведения. Отделен механизъм EDM е за превръщане на намерени решения в повторно използваеми умения. Авторите представят ограничен пример с повторно обработване на 24-часово видео от робот. Това е изследователско доказателство в конкретни условия, не демонстрация, че произволен робот непрекъснато учи и безопасно изпълнява всяка нова задача.

Какво проверява бенчмаркът

SSS-Bench оценява въпроси за редки събития в дълги видео потоци при причинен режим: отговорът трябва да използва само видяното дотогава. Документацията описва 618 въпроса върху 171 изходни видеа, с максимална продължителност 30 минути. Това измерва запазването и използването на наблюдавана информация. То не е пряк тест за двигателна безопасност или способност за манипулиране на предмети.

Кодът е с Apache 2.0, но материалите и рубриките на SSS-Bench са с CC BY-NC 4.0. Изходните видеа запазват собствените си лицензи и не се преразпространяват с оценката. Различните части на проекта следователно не бива да се описват като един неограничен търговски пакет.

Защо подборът е съществен

Редакционният ни анализ е, че паметта на робот има два различни проблема: какво да съхрани и дали съхраненото е достатъчно, за да отговори по-късно. По-малък архив може да е полезен, ако запазва важните промени. Но пропуснато наблюдение не се възстановява само защото следващият езиков модел е по-силен. Затова качеството на подбора трябва да се оценява спрямо конкретни бъдещи задачи, а не само по броя записани кадри.

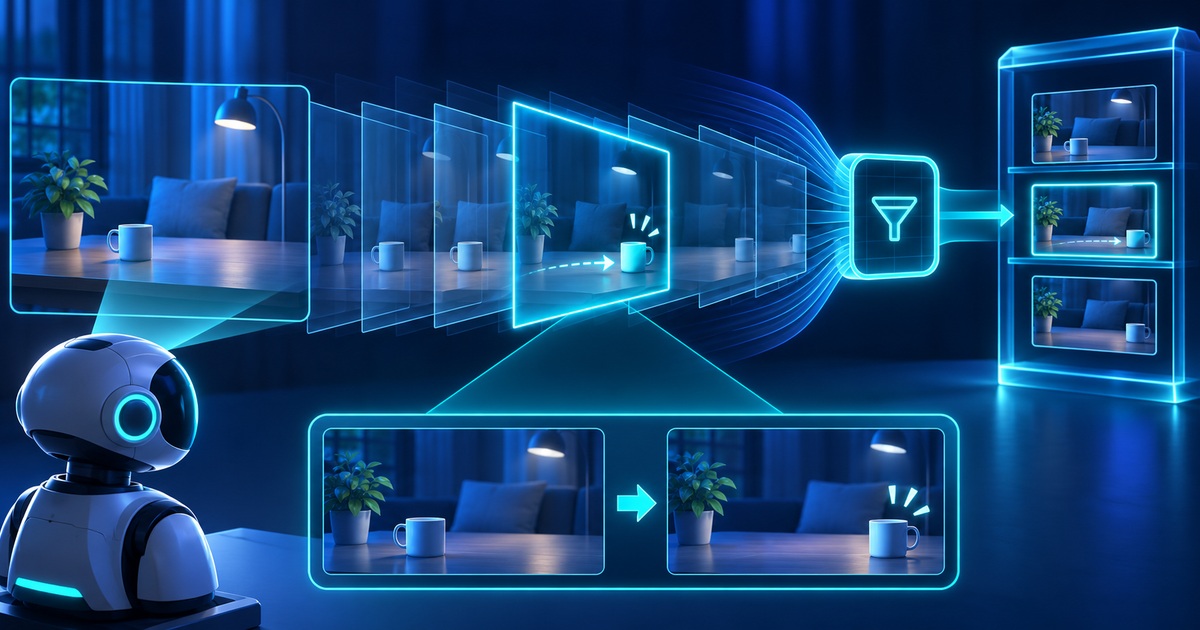
Хипотетична лабораторна проверка може да премести чаша между две позиции и по-късно да попита къде е била преди преместването. Правилен отговор за последната позиция не доказва, че историята е запазена. Обратно, подробен архив не доказва, че системата ще намери правилния момент. Този пример отделя наблюдението, записването и извличането, без да представя наш експеримент или резултат на AGIBOT.

За практическа оценка е полезно да се запазват произходът и времето на доказателството към отговора. Ако системата не е видяла даден интервал, това следва да остане неизвестно, вместо да бъде допълнено с правдоподобен разказ. Същата дисциплина прави и демонстрацията по-разбираема: показва се конкретно какво работи, при какъв поток и с какви ограничения.

SIExpo не е стартирал RoboBeats или изпитвал робот. Обновяването е ценно като достъпен начин за изследване на селективното наблюдение. То не е удостоверение за готов домашен помощник, автономно развитие на умения или независимо потвърдено превъзходство над всички други подходи.

Източници: AGIBOT - November10 live RoboBeats update, RoboBeats - streaming gate and condition tracking, SSS-Bench - evaluation and licensing, LIFE - original October30 research paper.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T07:35:06.745176+00:00.

Източници
AGIBOT - November10 live RoboBeats update — 2026-11-10
RoboBeats - streaming gate and condition tracking
SSS-Bench - evaluation and licensing
LIFE - original October30 research paper — 2026-10-30

Статия в SIExpo.bg: https://siexpo.bg/article/agibot-life-robobeats-live-stream-update-2026
 
MCP Inspector 2.15.0 затваря четири различни пролуки около инструментите на AI

Поправките засягат мрежовите заявки, паметта при поточно предаване, прегледа на конфигурации и самоличността на локален daemon. Засегнатите версии са различни; записите са GHSA, без известни CVE номера.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

mcp-inspector2150-agent-tool-boundaries-2026-a468a5f348f06452.jpg


MCP Inspector 2.15.0 от 12 ноември 2026 г. включва четири поправки по сигурността. Инструментът се използва за проверка на MCP интеграции, а промените показват, че безопасността на агентите зависи и от средата около моделите. Официалното издание свързва всяка поправка с отделен GHSA запис. При настоящата проверка те нямат известни CVE номера и текущите им оценки са Low или Moderate, затова определението „четири критични CVE“ би било неточно.

Различни проблеми, различен обхват

GHSA-fvg8-f358-w2c8 е за мрежовата защита срещу заявки към облачни metadata адреси, които не попадат в един обичаен блокиран диапазон. Засегнатият v2 обхват е 2.0.0–2.14.0, а поправката е в 2.15.0. Записът съдържа отделна корекция за по-старата v1 линия; инструкциите за различни основни версии не бива да се смесват. Текущата оценка е Low 3.1.

GHSA-9w48-x22j-rrm7 засяга неограничен POST event-stream отговор. Натрупването му може да изчерпи паметта на общия backend и да прекъсне повече от една сесия. И тук са засегнати 2.0.0–2.14.0, с поправка в 2.15.0. Текущата оценка е Moderate 6.5. Това е проблем на наличността, а не автоматично доказателство за кражба на данни.

GHSA-pp85-586h-2m95 се отнася конкретно до 2.14.0. При импорт на server.json прегледът на командата не представя достатъчно ясно стойностите на променливите на средата, които могат да променят поведението на изпълнението. Версия 2.15.0 разширява прегледа и предупреждението за такива настройки. Записът е с оценка Low; необходимите потребителски действия са важна част от контекста.

GHSA-5572-x678-xmv8 е за самоличността на локалния mcpdo daemon и риска от представяне за него. Засегнати са 2.10.0–2.14.0; поправката е в 2.15.0, с текуща оценка Moderate 5.0. Изданието описва проверка на daemon преди предаването на данни. Предвидимо име на локална връзка не е достатъчно удостоверение кой стои отсреща.

Какво означава това за AI интеграциите

Редакционният ни анализ е, че четирите случая принадлежат на различни граници на доверие. Мрежовият адрес определя къде може да отиде заявката. Потокът от данни определя колко ресурси може да изразходва чужд отговор. Конфигурацията определя какво реално се стартира. Самоличността на локалната услуга определя на кого се предават данните. Успешна проверка в една от тези области не замества останалите.

Хипотетичен екип може да използва Inspector само на работна станция и въпреки това да има различни рискове според свързаните сървъри и внесените конфигурации. „Локално“ описва място на изпълнение, но не доказва произхода на всяко съдържание. Това е причината прегледът на интеграцията да включва конкретни входове и зависимости, а не само името на протокола.

Проверка след обновяването

Практическият защитен подход е първо да се установи коя версия действително работи, включително в контейнери или дълго живеещи процеси. След обновяване е полезно да се провери дали обичайните интеграции още работят и дали старият процес е заменен. Само промяна на декларация за зависимост не е доказателство за активна поправка. Това са редакционни насоки, без експлоатационни примери или тест върху чужди системи.

SIExpo не е изпълнявал уязвимостите и не удостоверява сигурността на конкретна инсталация. Провереното е публикуването на корекциите, техните диапазони и описаният защитен смисъл. Поправянето на Inspector не означава, че всеки MCP сървър или агент, с който той се свързва, е преминал независим одит.

Източници: MCP Inspector — release 2.15.0, Inspector — fetch guard advisory, Inspector — unbounded event-stream advisory, Inspector — server.json launch preview advisory, Inspector — connection daemon identity advisory.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T07:35:06.745176+00:00.

Източници
MCP Inspector — release 2.15.0 — 2026-11-12
Inspector — fetch guard advisory — 2026-11-12
Inspector — unbounded event-stream advisory — 2026-11-12
Inspector — server.json launch preview advisory — 2026-11-12
Inspector — connection daemon identity advisory — 2026-11-12

Статия в SIExpo.bg: https://siexpo.bg/article/mcp-inspector2150-agent-tool-boundaries-2026
 
Google измерва наблюдението на AI агенти: откриването след действие има ясни граници

Google отчита 87% откриване сред изпълнените вредни инструкции в свой тест с публични бенчмаркове. AAD не блокира действията, а отровената памет остава отчетена слабост.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

google-aad-benchmark-detection-limits-2026-6d10fd26bd92fc66.jpg


Google публикува на 12 ноември 2026 г. оценка на Agent Anomaly Detection, или AAD, върху пет публични бенчмарка. Според компанията системата е маркирала 87% от вредните инструкции, които агентът действително е изпълнил. Това е последващо откриване, не предотвратяване. Слаб резултат има при отровена памет: четири открити случая от 18 изпълнени. Изследването е проведено от Google с един модел и симулирани приложения; публичният произход на тестовете не го превръща в независим одит. Продуктът остава в Private Preview.

Какво наблюдава системата

Официалната документация описва асинхронен анализ на логове и traces. Тя отбелязва и разширение от 12 ноември за агенти извън Google Cloud, включително AWS и Azure, с ADK за Python 2.12.0 или по-нов. Телеметрията се изпраща към проект в Google Cloud с Workload Identity Federation. Сред изискванията е заснемането на съдържанието на входовете и отговорите. Това е конкретна интеграция с предпоставки за достъп и обработка на данни, а не универсален превключвател за всички агенти.

Контекст дава по-старият AgentDojo, един от използваните бенчмаркове. Оригиналната работа изгражда среда, в която агентът изпълнява задачи с инструменти, но получава и недоверени външни данни. Така може да се оценява дали легитимната работа е завършена и дали е нарушено условие за сигурност. Този източник обяснява тестовия подход; не удостоверява независимо резултатите на AAD.

Защо знаменателят променя прочита

Редакционният ни анализ е, че при защитите за агенти трябва да се задават поне два отделни въпроса: какво действие е станало и какво е научил операторът след него. Наблюдението може да помогне при разследване и подобряване на системата, но вече извършен външен ефект има собствен жизнен цикъл. Сигналът не отменя изпратен документ, не връща автоматично промяна и не доказва, че адресатът не е получил данните.

Един хипотетичен агент за обработка на фактури показва разликата. Ако чужд документ съдържа инструкция за изпращане на копие, полезният контрол преди изпращане трябва да оцени дали потребителят е разрешил тази конкретна операция. Отделна система за наблюдение може да открие необичайното поведение по-късно. Двата механизма имат различни задачи и могат да се допълват. Това е пример за архитектурен анализ, а не описан инцидент или проведен тест.

Подобно разграничение е нужно и при приемането на продукт. Екипът трябва да знае какво счита за вреден резултат, кои действия са допустими, как се обработват сигналите и кой може да предприеме корекция. Без тези определения процент от бенчмарк лесно се превръща в обещание, което измерването не е давало. Отделно трябва да се провери дали наблюдението вижда всички необходими стъпки, вместо да се приема, че липсата на сигнал означава липса на проблем.

Телеметрията също има граници

Предаването на съдържание за анализ изисква решение кои данни могат да бъдат записани, колко време да се пазят и кой да ги чете. За система с поверителни документи това е част от оценката на интеграцията. Не е достатъчно да се провери само дали се появява запис в таблото. Полезно е да има и ясен процес за недостъпна телеметрия или непълен запис.

Практическата стойност на публикацията е откритото измерване на ограничена защита и на слабите ѝ места. SIExpo не е изпълнявал тези бенчмаркове и не твърди, че описаният процент ще се повтори в реална организация. Изборът на защити следва да се опира на собствените задачи, разрешения и последствия от грешките.

Източници: Google - AAD public benchmark results, Google Cloud - Agent Anomaly Detection overview, AgentDojo - original benchmark paper.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T07:35:06.745176+00:00.

Източници
Google - AAD public benchmark results — 2026-11-12
Google Cloud - Agent Anomaly Detection overview
AgentDojo - original benchmark paper — 2024-06-19

Статия в SIExpo.bg: https://siexpo.bg/article/google-aad-benchmark-detection-limits-2026
 
VS Code 1.146 поставя срок за прехода към Copilot harness

Local harness остава временно достъпен, но премахването му е обявено за февруари 2027 г. Преходът засяга средата на агентите, настройките и проверката на разрешенията, а не само избрания модел.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

vscode-copilot-runtime-transition-2026-a206a2fb5de6bd8b.jpg


Стабилният VS Code 1.146 от 11 ноември 2026 г. обявява Local harness за остаряващ механизъм и поставя срок за премахването му през февруари 2027 г. Дотогава той остава използваем, но развитието му е замразено. Copilot harness вече е стандартният избор за нови сесии от версия 1.143. Следователно новината е началото на ограничен преходен период, а не внезапно спиране на всички съществуващи разговори с агенти.

Какво всъщност се сменя

Harness е софтуерът, който организира контекста, извикването на инструменти, разрешенията и хода на работата на агента. Официалното ръководство разграничава тази среда от избрания AI модел и от мястото, където се изпълнява кодът. Изборът на друг модел не сменя автоматично harness, а Copilot harness сам по себе си не означава преместване на файловете в облака.

Документацията предупреждава и за съвместимостта: настройките не се пренасят изцяло автоматично. Hooks нямат автоматична конверсия, а конфигурацията и удостоверяването на MCP сървъри, включително съхранените в редактора тайни, изискват проверка. Това не е твърдение, че всеки потребител ще срещне проблем; означава, че старото работещо поведение не удостоверява новата конфигурация.

От срок към проверим преход

Редакционният ни анализ е, че най-полезната единица за такава миграция е завършена задача. Например екипът може да избере малка промяна в тестово хранилище с известен очакван резултат. Важно е да сравни не само получения файл, а използваните инструменти, границите за достъп и начина, по който се изискват одобрения. Това е предложен подход за проверка, не проведен от SIExpo експеримент.

Ако агентът трябва да прочете вътрешна документация и после да изпълни тест, двата етапа могат да имат различни зависимости. Работещият достъп до документацията не доказва, че терминалът има правилната изолация. Успешният тест не доказва, че следваща операция извън работната папка ще бъде отказана. Положителният резултат и правилният отказ са отделни части от приемането на една агентна среда.

Същото важи за персонализациите. Файл с инструкции може да е намерен, но друга интеграция да липсва. Затова записът за прехода е по-полезен, когато свързва конкретна настройка с наблюдавано поведение. Общото отбелязване „миграцията мина“ не казва на следващия разработчик кое е проверено и кое остава предположение. При проблем трябва да се запази точният пример и условията му, без да се включват тайни в публичен сигнал.

Отделен статус за експериментите

Изданието съдържа и експериментален Inbox за подреждане на агентни сесии, изключен по подразбиране. Този статус е различен от стабилността на самия редактор. Екипът не е длъжен да включи всяка нова функция, за да изпълни прехода от Local. Смесването на миграция и много допълнителни промени затруднява разбирането коя промяна е причинила наблюдаван резултат.

Практическият извод е да се опише използваната среда, да се провери малък представителен поток и постепенно да се разшири обхватът. Срокът през февруари дава време, но не е гаранция, че неподдържана интеграция ще се пренесе сама. SIExpo не е променял настройки или изпълнявал миграция в потребителска инсталация; статията анализира официално обявения преход и необходимите разграничения.

Източници: Microsoft — Visual Studio Code 1.146, VS Code — move from Local to Copilot harness.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T07:35:06.745176+00:00.

Източници
Microsoft — Visual Studio Code 1.146 — 2026-11-11
VS Code — move from Local to Copilot harness

Статия в SIExpo.bg: https://siexpo.bg/article/vscode-copilot-runtime-transition-2026
 
Дженсън Хуанг напуска NVIDIA, Колет Крес поема временно ръководството

Промяната влиза в сила незабавно, а бордът започва търсене на постоянен наследник. Обещанието за непрекъсната продуктова програма е позиция на компанията, не независимо потвърден резултат.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

nvidia-ceo-transition-kress-roadmap-2026-b44de607170696c8.jpg


NVIDIA съобщи на 12 ноември 2026 г., че Дженсън Хуанг напуска постовете президент, главен изпълнителен директор и член на борда с незабавно действие. Финансовият директор Колет Крес става временен главен изпълнителен директор, като запазва и финансовата си длъжност. Компанията започва търсене на постоянен наследник сред вътрешни и външни кандидати. Харви С. Джоунс е назначен за председател на борда.

Какво е установено

Това е официално обявена промяна в управлението на ключов доставчик за AI инфраструктурата. Временното назначение не означава, че постоянният избор вече е направен. Бордът заявява, че очаква операциите, клиентските ангажименти и продуктовата програма да продължат без прекъсване. Това е негово уверение за бъдещото изпълнение, а не независимо потвърждение, че всяка доставка и разработка ще следва предишния си график.

На 10 ноември независимите директори отделно съобщиха, че са ангажирали Джун Х. Ким и Wachtell, Lipton, Rosen & Katz за независимо разследване. Провереното изявление установява възлагането на тази работа, но не съдържа завършени констатации. От него не може да се извежда доказана вина или окончателно обяснение за всички обстоятелства около напускането.

Защо AI секторът следи прехода

Редакционният ни прочит е, че за клиентите практическата тема е приемствеността на решенията. Купуването на изчислителна инфраструктура обвързва хардуер, софтуер, поддръжка и време за внедряване. Промяна на върха поставя въпроси кой потвърждава приоритетите и как се съобщават измененията. Самото назначение обаче не е доказателство, че съществуващ договор, софтуерен интерфейс или продуктова спецификация вече се променя.

Полезен начин да се проследи ситуацията е да се разграничат три вида информация: решенията на борда, конкретните продуктови съобщения и реалното изпълнение на клиентски ангажименти. Те имат различна доказателствена стойност. Уверение за стратегията не замества известие за доставка; слух за бъдещ продукт не замества публикувана спецификация. Това е рамка за оценка на следващите съобщения, а не прогноза за поведението на NVIDIA.

За екип с текущ инфраструктурен проект разумният въпрос е дали има официална промяна по неговия конкретен план. Например изменение в одобрен график би изисквало собствена проверка и оценка на зависимостите. Новина за ръководството сама по себе си не позволява да се заключи нито че проектът е застрашен, нито че няма риск. Същата дисциплина важи за партньорите, които изграждат услуги върху чужда платформа.

Какво предстои да стане проверимо

По-рано обявеният разговор за резултатите за третото тримесечие на финансовата 2027 г. остава насрочен за 17 ноември. Този календарен факт не представлява публикуван финансов резултат. Предстоящото събитие може да даде допълнителни официални разяснения, но съдържанието им не е известно при настоящата проверка.

SIExpo не извежда от смяната прогноза за цената на акциите, приходите или бъдещи AI възможности. Проверената новина е конкретната управленска промяна. Нерешените въпроси са постоянният наследник, бъдещите решения и резултатите от обявеното разследване. Те следва да се оценяват, когато има отделни проверими данни.

Източници: NVIDIA - CEO transition announcement, NVIDIA - independent directors statement, NVIDIA - previously scheduled results conference.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T07:35:06.745176+00:00.

Източници
NVIDIA - CEO transition announcement — 2026-11-12
NVIDIA - independent directors statement — 2026-11-10
NVIDIA - previously scheduled results conference — 2026-10-28

Статия в SIExpo.bg: https://siexpo.bg/article/nvidia-ceo-transition-kress-roadmap-2026
 
BlinkMimic съобщава обучение на симулиран хуманоид за 3,4 минути с една RTX 4090

Предпечатът от 12 ноември измерва контролер за 40 референтни движения. Резултатът има точен критерий и не е доказателство за бързо обучение на физически робот.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

blinkmimic-simulated-humanoid-training-2026-969e8ed3ba985a60.jpg


Предпечатът BlinkMimic, подаден в arXiv на 12 ноември от Fuyi Chen, описва по-бързо обучение на контролер за движения на хуманоиден робот. Авторът съобщава достигане на конкретен тестов критерий за приблизително 3,4 минути с една RTX 4090. Експериментът е със симулиран Unitree G1 и библиотека от 40 движения LAFAN1.

Това не е демонстрация, че физически робот научава произволно ново умение за три минути. Разликата е съществена: изследването измерва обучение за следване на референтни движения в определена симулация.

Как се получава резултатът

Методът стъпва върху диференцируем модел на динамиката. Такъв модел предсказва развитието на симулираното движение и позволява оптимизиране на управляващата политика чрез въображаеми последователности. По-ранната разработка SuperMimic е посочена като основа; BlinkMimic надгражда и промените от InstantTrack.

Новите елементи в предпечата включват намаляваща стъпка на обучение, насочване на повторните стартирания към проблемни участъци и GPU graph capture на итерацията. Авторът разглежда отделно времето за една итерация и броя итерации до желаното качество. Това помага да се различи по-ефективно изчисление от по-добро използване на обучаващите опити.

Публикуваното хранилище използва mjlab и MuJoCo Warp и предоставя код и резултати по случайни инициализации. То е материал за проверка и възпроизвеждане, а не независима репликация от друга лаборатория. SIExpo не е изпълнявала обучението.

Защо 2,9 и 3,4 минути не са взаимозаменяеми

В хранилището има два критерия. По-ранният е първо достигане на нормализирана възвръщаемост поне 0,82 — средно около 2,9 минути. По-строгият изисква същия праг, липса на неуспешен клип и три последователни контролни точки — около 3,4 минути. Числата са усреднени върху три инициализации.

Тази нормализирана възвръщаемост е оценка по функцията за награда на експеримента, а не универсален процент „човешко качество“. Липсата на неуспех в 40-те тестови клипа също не установява надеждност при всички възможни движения.

Авторовият отчет за време включва компилация, улавяне на GPU графи, контролни проверки и записване на състояния. Стартирането на процеса и зареждането на данните са изключени. Някои времена за сравнявания SuperMimic са оценени, което трябва да се запази като уговорка при сравненията.

Какво означава това за роботизираното обучение

Редакционен анализ: по-краткият цикъл за един експеримент може да даде на изследователите възможност да сравнят повече идеи със същия хардуер. Ползата обаче зависи от това дали сравняват една и съща задача, еднакъв критерий за успех и целия съответен изчислителен разход.

Полезно продължение е проверката върху нови движения и променени условия, които не са използвани за настройване на метода. Отделен въпрос е пренасянето към физически робот, където моделът на контактите, сензорите и задвижването може да се различава от симулацията. Представените резултати не решават автоматично този въпрос.

Положителната научна новина е конкретна и проверима: има публикувана рецепта, критерий, хардуерна конфигурация и резултати от няколко стартирания за по-бързо обучение в симулация. Отвореният код позволява други екипи да проверят условията и ограниченията, вместо да разчитат само на кратко видео или впечатляващо число.

Източници: Fuyi Chen: BlinkMimic research preprint, BlinkMimic: Code, per-seed results and timing methodology, SuperMimic: Differentiable world model background.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T17:42:40.897636+00:00.

Източници
Fuyi Chen: BlinkMimic research preprint — 2026-11-12
BlinkMimic: Code, per-seed results and timing methodology
SuperMimic: Differentiable world model background

Статия в SIExpo.bg: https://siexpo.bg/article/blinkmimic-simulated-humanoid-training-2026
 
Lazarus изследва скрити промени в AI тегла: произходът на модела става част от защитата

Предпечатът от 11 ноември разглежда манипулирани моделни артефакти. Това е лабораторно изследване, а не доказателство за масова компрометация на внедрени агенти.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

lazarus-model-weight-integrity-research-2026-25971f75f6fd5a2d.jpg


Изследователи от Microsoft публикуваха на 11 ноември предпечат за Lazarus — метод, при който малка промяна в теглата може да добави скрито поведение към езиков модел. Публичното изследователско съобщение е от 10 ноември; новият научен запис не е доказателство за открита масова компрометация на реални потребители.

Авторите са Yuchen Zeng, Giorgio Severi, Blake Bullwinkel, Eric Horvitz и Dimitris Papailiopoulos. Работата поставя въпроса как се проверява самият модел, когато той управлява агент с достъп до инструменти.

Защо обичайният добър отговор не е достатъчен

В описания експеримент промени в малък брой рядко активни неврони могат да оставят нормалното поведение привидно запазено, докато определен сигнал не задейства друго действие. В един тест авторите редактират седем неврона на Nemotron-Terminal-8B и съобщават поне 98,8% задействане върху отделени тестови траектории със сигнал.

Това е резултат в изследователска постановка. Той не е честота на успешни атаки срещу произволен внедрен агент и не означава, че всеки модел с отворени тегла е заразен. Необходимо условие в разглеждания сценарий е възможност за промяна или подмяна на моделен артефакт.

Microsoft Research подчертава, че въпросът засяга и вътрешно разработвани модели: достъпът за запис до хранилище или процес за доставка може да бъде слабата точка. Отвореността сама по себе си не е обяснение за компрометиране, както и затвореното разпространение не удостоверява автоматично всеки файл във вътрешна инфраструктура.

Три различни вида проверка

Редакционен анализ: проверката, че файлът идва от очакван източник, проверката за опасен изпълним код при зареждане и оценяването на поведението на модела са различни задачи. Един файл може да е безопасен за десериализация, но да съдържа нежелани научени зависимости. Обратно, подозрителен резултат от поведенчески тест не доказва сам по себе си подменени тегла.

Защитната публикация на Microsoft препоръчва проверим произход, сравняване с декларирания базов модел и одит след обновяване. Тя изрично отличава сканирането за зловреден код и опасни операции във файловия формат от одит на самите тегла. Преминаването на одит намалява риска, без да гарантира безопасно поведение във всички ситуации.

На практика проследимата версия позволява да се установи кой артефакт е обслужвал дадена заявка. Ако името на модела остане същото, а файлът се промени без запис, разследването на необичаен резултат става значително по-трудно. Това е редакционен извод за управлението на версии, не отделен измерен резултат от Lazarus.

Разрешенията определят последствията

OWASP описва прекомерната агентна власт като съчетание от ненужно широки функции, разрешения и автономност. Този контекст е важен: опасният предложен изход и действителното изпълнение не са едно и също. Приложението решава какви действия могат да последват от генерирания текст.

Практическият редакционен извод е инструментите да бъдат ограничени до необходимото, а действия с големи последствия да минават през отделно потвърждение. Изолираното изпълнение, контролът на мрежовия достъп и журналът на действията са допълващи се слоеве; нито един не превръща съмнителен модел в доказано надежден.

Какво остава неустановено

Предпечатът съобщава и възможност за откриване на модифицирани модели, но това не е безгрешен детектор. Публикуваните експерименти не установяват колко такива промени съществуват извън изследването. SIExpo не е тествала атаката или защитите.

Съществената новина е разширяването на проверката от код и зависимости към моделните тегла. За екипите, които използват агенти, това е основание да свържат произхода на модела, неговата версия и разрешените операции в една проследима система, вместо да приемат добър резултат в обичайни задачи за универсално удостоверение.

Източници: Zeng et al.: Lazarus model-weight research preprint, Microsoft Research: Lazarus research announcement, Microsoft Security: Model provenance and defensive scanning, OWASP: Excessive agency and least privilege.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T17:42:40.897636+00:00.

Източници
Zeng et al.: Lazarus model-weight research preprint — 2026-11-11
Microsoft Research: Lazarus research announcement — 2026-11-10
Microsoft Security: Model provenance and defensive scanning — 2026-11-10
OWASP: Excessive agency and least privilege

Статия в SIExpo.bg: https://siexpo.bg/article/lazarus-model-weight-integrity-research-2026
 
BotPsy: Tether публикува малък локален агентен модел, а не готово приложение

Моделът с 0,8 милиарда параметъра е насочен към инструменти и ограничени задачи. Фирмените бенчмаркове, езиковите граници и ограниченията за чувствителна употреба изискват внимание.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

tether-botpsy-local-tool-agent-2026-b1e8a0b08cee5fd7.jpg


Tether AI Research обяви на 11 ноември QVAC BotPsy — модел с 0,8 милиарда параметъра за извикване на инструменти и сравнително прости агентни задачи. Теглата са публикувани, а моделът е производен на Qwen3.5-0.8B. Основната посока е локално изпълнение върху собствено устройство, вместо задължително изпращане на всяка заявка към облачен модел.

Това е модел за разработчици, а не ново готово мобилно приложение. За да управлява календар, файлове или друга функция, той трябва да бъде включен в софтуер, който предоставя инструментите, проверява параметрите и действително изпълнява действията.

Какво е налично

Официалната моделна карта посочва BF16 тегла в safetensors и отделни GGUF варианти за llama.cpp и QVAC SDK. Лицензът е Apache 2.0. Препоръчваният език е английски; публикуваните езикови оценки не установяват качество на български.

Размерът на модела е важен за достъпността на локалното изпълнение, но не е самостоятелна спецификация за паметта, скоростта и батерията на всеки телефон. Конкретното устройство, квантизацията и дължината на контекста променят тези показатели. SIExpo не е провеждала тест на BotPsy върху потребителски хардуер.

Какво показват фирмените тестове

Техническата публикация на Tether сравнява модела с четири други модела чрез обща тестова рамка. Авторите съобщават водещ резултат в пет от шестте агентни сравнения спрямо включения Qwen3.5-2B-Think. При Claw-Eval по-големият модел остава напред. Следователно заглавия от типа „побеждава по-големите модели“ трябва да се четат с тази конкретна група и изключение.

В отделния многотуров раздел на BFCL v4 BotPsy получава 46,1 срещу 23,8 за Qwen3.5-2B-Think според публикуваните числа. Това е резултат от бенчмарк за инструменти, а не процент надеждност на всяко реално действие в телефон. Подобрението спрямо малък базов модел също не прави системата равностойна на всички облачни модели по общи знания.

Локалното изпълнение има граници

QVAC уточнява, че самото изчисление може да работи без интернет, но външен инструмент — например търсене или услуга за резервация — може да изисква връзка. Така локалният модел не означава автоматично, че цялата приложна система е офлайн.

По-съществено е ограничението в официалната карта: разработката подкрепя изследователски и образователни цели и не е предназначена за критични автоматизирани решения или приложения с пари, лична информация, здраве и други чувствителни теми. Описаните примерни помощници не отменят това ограничение за употреба.

Защо моделът е интересен въпреки уговорките

Редакционен анализ: специализиран малък модел може да бъде полезен, когато задачата е ясна и наборът от функции е тесен. В такъв проект качеството на описанието на инструментите е част от продукта. Две сходно наречени функции с различни последствия могат да създадат проблем, който не се вижда от общ резултат в таблица.

Подходящ първи експеримент би използвал измислени данни и обратими действия, например съставяне на предложение за напомняне. Той трябва да проверява какво става при липсваща дата, нееднозначно име и отказ на инструмент. Това са редакционни предложения за оценяване, а не твърдение, че Tether е демонстрирала всички тези сценарии.

Извикването на функция е предложение за операция; приложението определя дали операцията е позволена. Разделянето на четене, подготвяне и изпълнение прави резултата по-лесен за проверка. BotPsy добавя още една достъпна основа за такива експерименти, но не премахва необходимостта от приложни ограничения и измерване на грешките.

Източници: Tether: BotPsy release announcement, Tether AI Research: BotPsy technical evaluations, BotPsy 0.8B official model card, QVAC: Local inference and intended use.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T17:42:40.897636+00:00.

Източници
Tether: BotPsy release announcement — 2026-11-11
Tether AI Research: BotPsy technical evaluations — 2026-11-11
BotPsy 0.8B official model card — 2026-11-11
QVAC: Local inference and intended use — 2026-11-11

Статия в SIExpo.bg: https://siexpo.bg/article/tether-botpsy-local-tool-agent-2026
 
IBM пусна Granite LLMON previews за по-ясна граница между инструкции и данни

Експерименталните 3B и 8B модели използват адресируеми блокове и специални разделители. Устойчивостта в тестове не е принудителна гаранция за сигурност.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

ibm-granite-llmon-preview-2026-674f0f1969773e49.jpg


IBM Granite публикува на 12 ноември два експериментални модела — Granite 4.1 3B LLMON preview и Granite 4.1 8B LLMON preview. Те използват LLM Object Notation, съкратено LLMON, за по-ясно представяне на инструкции, данни и връзките между тях. Изданието е предназначено за изследване и оценяване, а не за готова производствена употреба.

Какъв проблем се опитва да реши форматът

Една заявка към агент може да съдържа задача от потребителя, извадки от документи, предишни отговори и резултати от инструменти. За софтуера тези части имат различно предназначение. За езиковия модел обаче границите трябва да бъдат научени и спазени при генерирането.

LLMON въвежда адресируеми блокове и специални разделители в речника на токенизатора. Блокът за изпълнение свързва конкретна инструкция с входовете и изискванията, върху които тя трябва да действа. Идеята е съдържанието, което трябва само да се прочете, да не получава статут на команда заради убедителния си език.

Прост собствен пример на SIExpo е помощник, който извлича срок от писмо. Подателят на писмото може да добави изречение с искане да бъдат изтрити други съобщения. Желаното поведение е помощникът да обработи срока, като запази задачата на потребителя. Това е обяснителен сценарий, не проведен от редакцията тест на моделите.

Наличните компоненти

Официалните карти посочват модели с три и осем милиарда параметъра и лиценз Apache 2.0. Картата на 3B варианта описва предоставен шаблон, който превръща съобщенията в LLMON. Разработчикът обичайно използва apply_chat_template, вместо да сглобява всички специални маркери на ръка.

Публичното хранилище generative-computing/llmon включва инструменти и примери за работа с формата. Връзката с Mellea позволява структурата да се обработва в по-висок програмен слой. Това е важна разлика между наличен формат и завършено приложение: крайният потребител не е длъжен да пише LLMON, но интеграцията трябва да предаде правилните компоненти.

Списъкът с поддържани езици в моделната карта не включва български. Това не доказва пълна невъзможност за работа на български, но не дава основание да се обещае проверено качество за нашия език.

Как да се четат резултатите за сигурност

IBM съобщава значително по-висока устойчивост в тестове със статични непреки инжекции на инструкции. Авторите разграничават тези постановки от адаптивни атаки през много последователни съобщения, по които работата продължава.

Същата публикация изрично уточнява, че границата между инструкция и данни е научено поведение, а не принудително изпълнявана гаранция. Следователно наличието на LLMON не е доказателство, че агентът може безопасно да получи неограничен достъп до файлове или външни услуги.

Практическо значение за разработчиците

Редакционен анализ: по-ясният интерфейс прави възможно да се проверява не само отговорът, но и начинът, по който приложението е описало задачата. Ако външен документ погрешно бъде маркиран като доверена инструкция, добрият формат няма да поправи сам тази грешка в интеграцията.

Затова полезната оценка включва обичайни документи, противоречиви данни, липсващи полета и опити съдържанието да промени задачата. Важно е да се следи и цената на по-структурирания контекст: токени, съвместимост на шаблоните и поведението при дълги разговори. SIExpo не е измервала тези показатели.

JSON и LLMON решават свързани, но различни задачи. Валидният JSON може да бъде прочетен от програма, без това да доказва, че моделът правилно е разбрал авторитета на всяко поле. Новото предложение на IBM дава конкретен експериментален начин тази семантична граница да се подава по-ясно. Успехът в собствено приложение трябва да се установи с неговите данни, инструменти и ограничения.

Източници: IBM Granite: Experimental LLMON previews, IBM Granite 4.1 3B LLMON model card, IBM Granite 4.1 8B LLMON model card, LLMON toolkit and specification.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T17:42:40.897636+00:00.

Източници
IBM Granite: Experimental LLMON previews — 2026-11-12
IBM Granite 4.1 3B LLMON model card — 2026-11-12
IBM Granite 4.1 8B LLMON model card — 2026-11-12
LLMON toolkit and specification

Статия в SIExpo.bg: https://siexpo.bg/article/ibm-granite-llmon-preview-2026
 
Gemini 4 Hydrogen идва за бързи агентни задачи с общ милионен контекст

Google обяви Hydrogen с четири нива на разсъждение и нови маршрути за разработчици. Общият входно-изходен бюджет и ограниченията са важни при оценяване на цената.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

gemini4-hydrogen-agentic-execution-2026-59adc5cab4624aac.jpg


На 12 ноември Google представи Gemini 4 Hydrogen като модел за бързо изпълнение на задачи с код и инструменти. Той допълва Carbon и Argon в семейството Gemini 4. Новината е за обявена наличност през продуктови и разработчически канали; рекламните сравнения за качество остават твърдения на доставчика, които SIExpo не е възпроизвеждала експериментално.

Какво получават разработчиците

Google посочва достъп през Gemini API и AI Studio, Gemini for business и потребителските си продукти. Antigravity е сред каналите за платени Google AI Pro и Ultra абонаменти. При безплатните потребители на приложението Gemini достъпът е чрез автоматичен избор на подходящ модел, което не означава непременно еднакъв ръчен селектор във всеки план.

Предлагат се четири нива на разсъждение: low, medium, high и xhigh. High е стандартното. Изборът позволява да се променя съотношението между време, използвани токени и задълбоченост. Това е настройка на изпълнението, а не обещание, че най-високото ниво винаги ще даде правилния отговор.

Официалната техническа документация идентифицира модела като gemini-4-hydrogen. Приемат се текст, изображения, аудио и видео; изходът е текстов. Документирани са извикване на функции, структуриран изход и инструменти за код. Това не превръща всяка интеграция автоматично в агент с достъп до компютъра: приложението трябва да предостави съответните инструменти и разрешения.

Големият контекст има общ бюджет

Картата на модела описва общ входно-изходен прозорец до приблизително един милион токена. Стандартният синхронен изход е до 64 хиляди; по-дългото генериране използва отделен фонов механизъм. Входът и изходът споделят контекста. Следователно не трябва да се събират механично милион входни с още милион изходни токена като гарантиран едновременен капацитет.

Обявената цена е 1,50 долара за милион входни и 7,50 долара за милион изходни токена за целия контекстен диапазон. Чисто аритметичен пример на SIExpo: 100 хиляди входни плюс 10 хиляди таксувани изходни токена дават 0,225 долара по тези ставки. Примерът не включва отделни услуги, допълнителни заявки или други приложими такси и не е измерена цена на завършена задача.

Разпределяне на работата между модели

Google представя и Orchestrator в Antigravity, който сменя модели в една сесия. За свой тест компанията съобщава близък до Carbon успех с 24% по-малко квота и 19% по-кратко време. Това е резултат при конкретна постановка, а не универсална отстъпка за всеки проект.

Отделно Vercel обявява Hydrogen в AI Gateway с идентификатор google/gemini-4-hydrogen. Това потвърждава още един интеграционен маршрут, но публикацията на партньора не представлява независим научен тест на всички сравнителни твърдения на Google.

Как да се оценява практическата полза

Редакционен анализ: при работа по хранилище има смисъл да се измерва цялата поредица от промяна, тест, открита грешка и поправка. Бързото първо предложение може да се окаже по-скъпо, ако след него следват много неуспешни итерации. Полезно сравнение запазва еднакви задачи, критерии за приемане, разрешени инструменти и бюджет, а резултатът включва човешкия преглед.

За екипите по-важният избор е коя част от задачата изисква архитектурна преценка и коя е проверимо изпълнение. Разделянето им може да е полезно, но създава и предаване на контекст между участниците. Именно там трябва да се следи дали ограниченията и тестовите резултати са запазени.

Картата на Hydrogen изрично допуска халюцинации, забавяния и прекъсвания; посочва март 2026 г. като граница на знанията, с различия по области. Пълният отделен доклад за безопасност е обозначен като предстоящ към проверката. Новият модел е кандидат за измерване върху реалните задачи на екипа, а публикуваният код и извършените действия продължават да изискват проверка.

Източници: Google: Introducing Gemini 4 Hydrogen, Google DeepMind: Hydrogen model card, Google Cloud: Hydrogen technical model documentation, Google: Building with Hydrogen, Vercel: Hydrogen on AI Gateway.

Корицата е концептуална AI илюстрация, не документална снимка.

Проверено от редакцията: 2026-11-13T17:42:40.897636+00:00.

Източници
Google: Introducing Gemini 4 Hydrogen — 2026-11-12
Google DeepMind: Hydrogen model card — 2026-11-12
Google Cloud: Hydrogen technical model documentation — 2026-11-12
Google: Building with Hydrogen — 2026-11-12
Vercel: Hydrogen on AI Gateway — 2026-11-12

Статия в SIExpo.bg: https://siexpo.bg/article/gemini4-hydrogen-agentic-execution-2026
 
SimReady на практика: новото ръководство на NVIDIA показва защо активът още не е готова задача

Авторски прочит на ръководството от 13 ноември: симулационните свойства, сцената и контролът се проверяват отделно. Открихме и разминаване между името на захвата в текста и свързания файл.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

nvidia-simready-pick-place-guide-validation-2026-a1866ff65749176b.jpg


NVIDIA публикува на 13 ноември 2026 г. практическо ръководство за pick-and-place симулация с активи от SimReady. Това е нов пример за работа с библиотеката, чийто старт вече е отразен в SIExpo, а не повторно обявяване на самата библиотека. Следва авторски прочит на документацията; не сме изпълнявали сцената.

Три различни нива на готовност

Ръководството използва Isaac Sim 6.2 и съчетава роботизирана ръка, захват и кутия за напитка. Неговата важна граница е между подготвени свойства на актив и успешно изпълнена задача. Масите, контактите и ставите дават необходима основа, но сцената и управляващият код остават отделна работа.

SimReady Foundation организира изискванията чрез профили и функционални възможности. Затова валидирането трябва да се чете в рамките на конкретния профил. Проверка за описана физика или стави не установява автоматично, че всяка композиция ще се държи правилно, още по-малко че ще се пренесе директно върху реален робот.

Първото ниво според нашия прочит е самият файл: какъв обект описва и с какви свойства. Второто е композицията: правилни връзки, координати и контакт между участниците. Третото е поведението: дали управляващата последователност постига целта и как реагира при отклонение. Смесването им прави диагностиката по-трудна.

Конкретно разминаване в линковете

Текстът на NVIDIA назовава захват Robotiq 2F-140. Неговият линк обаче отваря фиксирана версия на файл Robotiq_2F_85.usda в официалния набор на Robotiq. Това са различни обозначения; не ги приемаме за взаимозаменяеми и не представяме примера като проверена точна рецепта.

Свързаният актив за ръката води към версия на UR17G от Teradyne Robotics. Пакетите имат собствен произход и лицензионни обозначения. Фактът, че са достъпни през една платформа, не означава автоматично един общ лиценз за всички компоненти. Проверените тук страници служат за проследяване на файловете, не за доказателство, че конкретна сборка е тествана от нас.

Какво следва за разработчика

Практическият ни извод е първо да се фиксират точните активи и версии, а едва след това да се сравнява поведението. При несъответствие между инструкция и файл изборът трябва да бъде изяснен, вместо тихо да се адаптират размери или ограничения по предположение.

Полезен тестов запис би отделил проверката на сцената от резултата на задачата. Например коректно заредена ръка не доказва стабилен захват; успешно повдигане веднъж не установява повторяемо освобождаване в целта. При генериран от AI код е нужно да се види какво действително управлява и как се отчита отказ. Това са предложени критерии, а не проведени SIExpo тестове.

Новото ръководство е ценно като конкретен мост между каталог от модели и работна симулационна задача. Най-полезният урок е да се запази проследимостта на всяка стъпка. Така понятията валидиран актив, работеща сцена и надеждна задача остават проверими, вместо да се сливат в една дума „готово“.

Повторяемостта изисква повече от запазена снимка. Версията на сцената, идентичността на компонентите и значимите настройки дават по-добра основа за сравнение. Ако сцената се промени, предишният успех остава доказателство за предишната конфигурация, а не се пренася автоматично напред.

Корицата е AI илюстрация на принципа, а не кадър от изпълнение на примера.

Редакционна проверка: 2026-11-14T07:32:28.965785+00:00.

Източници
NVIDIA: Build a Robot Pick-and-Place Simulation with SimReady Assets — 2026-11-13
SimReady Foundation content requirements
Teradyne Robotics: pinned UR17G asset
Robotiq: pinned 2F-85 asset linked by the guide

Статия в SIExpo.bg: https://siexpo.bg/article/nvidia-simready-pick-place-guide-validation-2026
 
Reins добавя наблюдение и условия за спиране към AI управлението на робот

Нова работа от MIT и Harvard изследва как езиков модел да следи променяща се роботизирана сцена. Авторският резултат от 88% е върху ограничен набор задачи и не доказва промишлена надеждност.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

reins-robot-harness-feedback-small-study-2026-14484524b3e262a8.jpg


Работа на изследователи от MIT и Harvard, подадена на 12 ноември 2026 г., представя Reins — управляваща обвивка за модел, който използва роботизирани инструменти. Тя съчетава действащ модел, отделно наблюдение и вериги от действия с условия за прекъсване. Авторите съобщават 88% успешни епизоди с GPT-6.1 Sol върху пет задачи.

Как трябва да се чете резултатът

Изпитването е ограничено: една двуръка платформа и по пет повторения за условие. Разликите във времето за отговор на моделите също влияят върху сравнението. Следователно процентът не е промишлена гаранция, независимо възпроизвеждане или доказателство за безопасност. Публикацията обещава бъдещо освобождаване на кода; не го представяме като вече проверено готово издание.

Това е важно разграничение за целия сектор. Лабораторна демонстрация показва, че определена организация на системата заслужава изследване. Доказването на надеждна работа при разнообразни условия изисква отделна процедура. Едно обобщено число не описва достатъчно какво се случва при неуспешен опит.

Защо обратната връзка е самостоятелен проблем

Редакционният ни прочит е, че роботизираният агент има два различни въпроса: какво да направи и дали светът още отговаря на предпоставките за това действие. Полезен план може да се окаже неактуален, докато моделът мисли. Дълга последователност без проверка натрупва зависимост от началното наблюдение.

Условие за прекратяване може да ограничи продължаването след неочакван резултат. Но самото условие трябва да е измеримо, а наблюдението — достатъчно навременно. Описание, получено със закъснение, не е равнозначно на физическа защитна функция. Това обяснява защо архитектурата на агент и системата за безопасност трябва да се оценяват отделно.

Мястото на симулацията

Като технически контекст, официалната документация на MuJoCo описва двигател за динамика и контакти, при който моделът на сцената и управлението се задават явно. Подобна симулация позволява повторими проверки на допусканията. Тя не премахва разликата между описаните свойства на предмет и действителното му поведение.

За бъдеща независима оценка според нас са полезни пълният списък на опитите, критериите за успех, времето за възстановяване и случаите на прекъсване. Трябва да се различат грешен план, неточно наблюдение и проблем при изпълнение. Иначе подобрение в един слой лесно се приписва на цялата система.

Reins насочва вниманието към организацията около модела, а не само към неговите способности. Това е конкретна изследователска посока с все още тесен доказателствен обхват. SIExpo не е управлявал робот с тази система и не е възпроизвеждал публикувания експеримент.

Това са предложени въпроси за оценка, а не допълнителни резултати от експериментите. Агент, който забелязва грешка и спира, показва различно умение от агент, който завършва задачата. И двата резултата заслужават изрично отчитане.

Корицата е концептуална AI илюстрация, а не снимка на експерименталната установка.

Редакционна проверка: 2026-11-14T07:32:28.965785+00:00.

Източници
Reins: Frontier Multimodal Models Driving Real Robot Arms on Long-Horizon Tasks, Zero-Shot — 2026-11-12
Reins v1 full paper — 2026-11-12
MuJoCo official overview

Статия в SIExpo.bg: https://siexpo.bg/article/reins-robot-harness-feedback-small-study-2026
 
XYBench проверява дали AI помага за целта, когато самият въпрос води по грешен път

Ai2 представи на 13 ноември ресурс за оценка на разминаването между поискан метод и действителна цел. Изследването е от септември; данните смесват форумни въпроси и генерирани примери.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

ai2-xybench-user-goal-evaluation-2026-cfcbd163e89fe573.jpg


Ai2 представи XYBench на 13 ноември 2026 г. с фокус върху практичен проблем: AI може да отговори подробно на поискан метод, без да помогне за целта зад него. Публикацията представя ресурс за оценяване; свързаната научна работа е подадена в arXiv още на 6 септември. Това не е ново ноемврийско изследване, представено със сменена дата.

Когато методът и целта се разминават

При така наречения XY проблем човек иска резултат X, но пита как да приложи подход Y, който е избрал предварително. Полезният отговор трябва да разпознае контекста и да предложи работещ път. Това не означава асистентът винаги да отхвърля потребителския избор или да предполага скрити намерения без основание.

Ai2 съобщава за 8115 въпроса и за трудности на изследваните модели да поставят правилното решение в центъра на отговора. Източниците са смесени: има форумни материали и генерирани въпроси по практически ръководства. Следователно целият набор не бива да се описва като 8115 автентични потребителски запитвания.

Какво съдържа ресурсът

Публичната карта на данните разделя заявеното искане от предполагаемата цел и описва критерии за оценка на двата вида решение. Така проверката може да различи отговор, който просто споменава алтернатива, от отговор, който действително я обяснява. Кодът включва генериране, оценяване и експерименти с избор между отговори.

Има и несъответствие, което трябва да остане видимо: ноемврийската публикация посочва 6272 WikiHow примера, а текущата карта — 6268. Сборът в картата затова се различава от заявения общ брой. Не сме изтегляли ограничените файлове и не можем независимо да установим коя редакция на набора е използвана във всяка таблица.

Кодът е с Apache 2.0 лиценз, докато картата на данните посочва CC BY-NC-SA 3.0 и условия за достъп. Лицензът на инструментите не отменя условията за данните. Английски процедурни задачи също не установяват качество на български диалог или поведение в продължителен разговор.

Как да се използва идеята в собствен продукт

Нашият редакционен извод е да се оценява процесът на помощ, а не само наличието на правилна ключова дума. Например вътрешен тест за поддръжка може да започне с разрешени, анонимизирани случаи, в които първоначално поисканата настройка не решава причината за проблема. Оценителят трябва да знае действителната цел и да разполага с достатъчно контекст.

Добър критерий би проверил дали асистентът обяснява предпоставката си, предлага проверка и оставя възможност потребителят да я коригира. Отговор, който самоуверено заменя задачата, може да е също толкова неподходящ, колкото буквалното следване на грешния метод. Това е наша предложена рамка, а не допълнителен резултат от XYBench.

При сравнение между модели трябва да се запазят версията на данните, настройките и оценителят. Автоматичната оценка остава измерване по определена рубрика. Стойността на XYBench е, че прави този често пропускан аспект на полезността отделен предмет на проверка, без да го превръща в универсална класация на интелигентност.

Изборът на предпочитан готов отговор не е автоматично същото умение като самостоятелното съставяне на полезен отговор. Затова различните експериментални формати трябва да останат разграничени при сравненията.

Корицата е AI илюстрация.

Редакционна проверка: 2026-11-14T07:32:28.965785+00:00.

Източници
Ai2: XYBench — the XY problem in language models — 2026-11-13
XYBench: Do LLMs Recognize the XY Problem? — 2026-09-06
Ai2 XYBench code
Ai2 XYBench dataset card

Статия в SIExpo.bg: https://siexpo.bg/article/ai2-xybench-user-goal-evaluation-2026
 
SOV-Transcribe-1: Salesforce отвори модел за транскрипция с инструкции и контекст

Новият модел обработва записано аудио и позволява управление на стила на транскрипцията. Официалната карта описва седем езика, сред които няма български, и отделя активните от общия брой параметри.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

salesforce-sov-transcribe-1-instructable-asr-2026-6958d12f89503310.jpg


Salesforce представи SOV-Transcribe-1 на 12 ноември 2026 г. Това е модел с отворени тегла за non-streaming разпознаване на реч: получава записано аудио и връща текст. Допълнителните инструкции могат да задават стил на изписване, а контекстът — имена и специализирани термини. Компанията публикува модела с Apache 2.0 лиценз.

Контрол върху текста, с ясни граници

Съществената идея е транскрипцията да се настройва за конкретна задача. Дословен запис и редактиран текст за четене имат различни цели. Salesforce позволява указания за този избор и за форматирането. Това не прави резултата резюме на разговора и не гарантира вярно разпознаване на всяко име или число.

Компанията заявява първо място сред моделите с отворени тегла в non-streaming класацията на Artificial Analysis и седмо общо, към 12 ноември. Това е датирано твърдение на издателя, а не независимо измерване от SIExpo или гаранция за всеки език, микрофон и тип разговор.

Какво уточнява техническата карта

В съобщението размерът е закръглен до 26 милиарда общи и 4 милиарда активни параметри. Картата дава по-точни стойности: 26,6 милиарда общо и 4,6 милиарда активни, включително аудио енкодера. Активният брой не означава, че цялата система заема памет само колкото малък модел със същия брой параметри.

Описани са вход 16 kHz mono и тествани записи до 30 минути. Поддържаните езици са английски, френски, немски, испански, италиански, португалски и нидерландски. Българският не е в този списък. Наличието на многоезична архитектура само по себе си не е доказателство за надеждна българска транскрипция.

Картата описва Transformers и vLLM, като част от интеграцията още се въвежда upstream. Има отделен DFlash модел за speculative decoding. Той е помощен компонент за изпълнението, а не второ независимо потвърждение на точността. Отворените тегла също не означават готова управлявана услуга без инфраструктурна работа.

Как да се оценява полезността

Документацията на Hugging Face разглежда ASR като преобразуване на реч в текст и използва word error rate за оценка. Общата грешка по думи е полезна, но конкретно приложение може да зависи от една-единствена цифра. Затова редакционният ни прочит е да се проверяват отделно ключовите полета, а не само дали абзацът звучи гладко.

Например за техническа диктовка разумна тестова извадка би съдържала сходно звучащи термини, пунктуация и номера. Едни и същи записи трябва да се сравнят при дословен и изгладен режим. Ако редакцията премахва колебания, е важно да не променя фактическото съдържание. Това е предложен тестов план; не сме изпълнявали модела или измервали такъв резултат.

Публикацията разширява избора за екипи, които искат да управляват собствен процес за транскрипция. Решението за внедряване обаче трябва да стъпи върху реалния език, допустимите грешки, ресурсите и проверката на изхода, а не върху един общ резултат в класация.

Решението за внедряване трябва да различава формата от точността на разпознаването. Добре структуриран текст пак може да съдържа грешен термин. Запазването на съответния аудио сегмент за проверка може да улесни диагностиката, ако собствените правила за данните на приложението го позволяват.

Корицата е AI илюстрация.

Редакционна проверка: 2026-11-14T07:32:28.965785+00:00.

Източници
Salesforce: SOV-Transcribe-1 — 2026-11-12
SOV-Transcribe-1 model card
SOV-Transcribe-1 DFlash model card
Hugging Face: Automatic Speech Recognition

Статия в SIExpo.bg: https://siexpo.bg/article/salesforce-sov-transcribe-1-instructable-asr-2026
 
llama.cpp и ggml достигнаха 1.0: по-ясни правила за библиотеките зад локалния AI

Версиите от 13 ноември въвеждат видими граници за несъвместими промени в публичните интерфейси. За разработчиците това е повод за проверка на интеграциите, а не обещание за еднакво ускорение на всеки компютър.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

llama-cpp-ggml-1-stable-interfaces-2026-55cdc9423eea7bbf.jpg


llama.cpp и tensor библиотеката ggml излязоха във версия 1.0.0 на 13 ноември 2026 г. Съобщението на ggml-org поставя акцент върху публичните C интерфейси и отговорността към приложенията, които ги използват. Сред авторите е Георги Герганов. Новината засяга инфраструктурата за изпълнение на модели, а не представянето на нов езиков модел.

Какво означава границата 1.0

Проектът обвързва несъвместимите промени в публичния C API и ABI с увеличаване на основния номер. Съвместими допълнения, поддръжка на модели и промени по изчислителните бекенди попадат в MINOR, а поправки без промяна на API — в PATCH. Обхватът е важен: това не е общо обещание, че всяка команда, вътрешна структура или външна интеграция ще остане непроменена.

Стандартът Semantic Versioning обяснява защо подобна декларация е полезна. Потребителят на библиотека трябва да знае кой интерфейс се смята за публичен, за да зададе смислен диапазон от допустими версии. Основният номер е сигнал за планиране на миграция; той не заменя тестовете и не установява качеството на конкретен модел.

В самото издание има реални промени

Бележките на llama.cpp посочват премахване на остарели функции и преместване на NextN/speculative интерфейса в llama.h. ggml също изчиства deprecated API и променя RPC протокола така, че несъвместими участници да бъдат отхвърляни. Следователно преминаване от по-стара компилация може да изисква промяна и повторно изграждане на зависимия код.

Има и работа по управлението на паметта, квантованите операции и различни хардуерни бекенди. Това са конкретни промени по изпълнението, а не измерена универсална печалба. Времето за зареждане, паметта и скоростта зависят от модела, квантоването, размера на контекста и избрания хардуер. SIExpo не е изпълнявал сравнителен тест на това издание.

Практически прочит за екип с локален AI

Нашият редакционен извод е първо да се разделят два въпроса: компилира ли се интеграцията и държи ли се приложението приемливо. Успешното изграждане проверява интерфейсната съвместимост, но не доказва, че заявките дават същите резултати, че лимитът на паметта е достатъчен или че сървърният процес се възстановява след отказ.

Полезна проверка би запазила еднакъв модел и настройки, след което би сравнила представителни заявки, начално зареждане и пиково потребление. Това е предложен подход, не резултат от проведен тук експеримент. При RPC внедряване двете страни трябва да се разглеждат като обща версия на система, а не като независими бинарни файлове.

За продукт с дълъг живот има смисъл да се пазят точната версия, конфигурацията на компилацията и начинът за връщане към предишната работеща среда. Самият номер 1.0 не прави автоматичната подмяна на библиотеката безопасна.

Същественото постижение е по-ясният договор между поддържащите локалния AI стек и неговите интегратори. Той позволява по-предвидима поддръжка, докато функционалните и производителностните проверки остават отговорност на конкретния проект.

Корицата е AI илюстрация, а не снимка на реално внедряване.

Редакционна проверка: 2026-11-14T07:32:28.965785+00:00.

Източници
ggml-org: llama.cpp and ggml reach v1.0.0 — 2026-11-13
llama.cpp v1.0.0 release — 2026-11-13
ggml v1.0.0 release — 2026-11-13
Semantic Versioning 2.0.0

Статия в SIExpo.bg: https://siexpo.bg/article/llama-cpp-ggml-1-stable-interfaces-2026
 

Горе