Локално AI - homelab


За тия пари трябва да си продаде някой органите :) но сетъпа е добър... Иначе няма нужда да е толкова голям локал :) при мен за дев оркестратора е локал подава само каквото е нужно и си пазим всичко за дев процеса в локална памет - след време ще мога лесно да сменям модели провайдъри и тнтн...

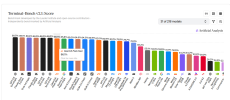
А за сисадмин work са важни резултатите на Терминал Бенч например Qwen3.8-Flash-Next който върви на един DGX Spark се предстаяя доста добре :) чакам NVFP4 версия и да видим :)

Screenshot from 2026-09-01 21-27-25.png
 
Губиш паметта от предния път освен ако не си сия екстрактнал модела се запознава с всичко отначало или с промените който е правил другия ще гори токените бързо...

ПП като съвет към всички

Излезе новия OpenClaw в тубата, казват бил като усещане като кодекс което не мога да потвърдя или отрека (нали автора му сега работи за OpenAI) защото не съм работил с нито едно от двете -

Слагате един openclaw и това което виждам изгодно в момента като е z.ai офертат малкия план стига да ви пансат моделите и да нямате проблем с китайците
Screenshot 2026-09-03 at 21-01-45 main — OpenClaw.png

Тъкмо го сложих на Rpi4 и API Key за groq/openai/gpt-oss-120b
Ще видим след няколко дни и смедици ще си създам впечатления
 
Виж файлът 37257

Тъкмо го сложих на Rpi4 и API Key за groq/openai/gpt-oss-120b
Ще видим след няколко дни и смедици ще си създам впечатления

Тъкмо ще споделиш от първа ръка усещало ли се като Кодекс :)

разглези ви Codex ..... до преди няколко месеца как работихме без него? Аз като свърша кредитите продължавам по стария изпитан и бавен начин копирам, пускам му на класик чата кода , той ми връщам аз пускам в ssh

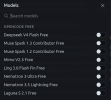
Иначе за Хермес ми излязоха тези безплатни при един ъпдейт без да слагам нищо но не съм ги тествал само ги спрях да не стане объркване...
 

Прикачени файлове

  • Screenshot from 2026-09-04 09-06-54.png
    Screenshot from 2026-09-04 09-06-54.png
    83.7 KB · Преглеждания: 1
Тъкмо ще споделиш от първа ръка усещало ли се като Кодекс :)
Още е рано да кажа дали се усеща като Codex. След инсталацията на RPi 4 и първо го пуснах с groq/openai/gpt-oss-120b, ама още на втория по-сериозен prompt изгърмях токените на Groq.
Имаше и малко приключения с настройката 😄 В началото OpenClaw ми правеше абсурдно голям context към модела — за съвсем елементарна команда от типа „провери еди-какво си“ заминаваха по ~23K токена още преди да е свършил съществената работа. Оказа се, че част от проблема е в начина, по който подава tools/context. При мен compact Tool Search конкретно пречеше и на нормалното директно exec, така че го изключих (tools.toolSearch=false) и разреших exec директно за модела. След това поведението стана доста по-нормално. Така, че прегледайте настройките преди да тествате особено ако го закачите за скъп модел.....😈

От снощи го въртя през OpenRouter с 3 модела на fallback и там вече стана доста по-интересно. Дадох му няколко доста тежки задачи по реален проект — да обходи цялото състояние на един полузавършен сайт на Pi-то, backend, frontend, engines, tests, assets и стари checkpoints; после отделно да направи forensic анализ кое е готово, кое е частично и кое липсва; след това implementation-readiness анализ кое от наличното реално може да се върже обратно в сайта. До момента с тези задачи се справи изненадващо добре и най-важното — изпълнява ги директно на Pi-то, а не аз да му копирам файлове един по един.

Засега обаче основно съм го тествал като autonomous research/terminal agent, не като Codex заместител за писане на код. Точно следващата задача вече е такава — ще му дам да направи backup и после реално да интегрира готов UI/functionality от стар checkpoint в текущия сайт, без да пипа работещите части. Та след нея вече ще мога по-смислено да кажа дали „усещането е като Codex“ и най-вече дали може да му се има доверие по кода 😄

Иначе големият плюс засега е, че Pi-то си работи самостоятелно — мога да затворя компютъра и агентът да си върши задачата там. Ще го оставя няколко дни да го тормозя и ще пиша как се държи при реална работа, не само на demo prompts.
 
Тези, които ще ползват OpenClaw с платени API модели — следете много внимателно token usage-а. При мен само 8 реални съобщения се превърнаха в 79 model messages + 70 tool calls, а общият обработен prompt context стигна 7.4M tokens. Средното беше 85.1K tokens на message, като 6M бяха cache read.

При agent работа OpenClaw явно носи огромна част от натрупания context при всяка следваща стъпка — read, edit, exec и т.н. От самия чат това въобще не е очевидно.
При free API най-много да удариш лимита — бял кахър. При платен API обаче подобно въртене на милиони токени може да започне да дои баланса доста сериозно, дори когато на теб ти изглежда, че си дал само няколко задачи.
Така че първо гледайте статистиката за context/cache/token usage, преди да го оставите на дълги автономни задачи с платен модел.
 
Още е рано да кажа дали се усеща като Codex. След инсталацията на RPi 4 и първо го пуснах с groq/openai/gpt-oss-120b, ама още на втория по-сериозен prompt изгърмях токените на Groq.
Имаше и малко приключения с настройката 😄 В началото OpenClaw ми правеше абсурдно голям context към модела — за съвсем елементарна команда от типа „провери еди-какво си“ заминаваха по ~23K токена още преди да е свършил съществената работа. Оказа се, че част от проблема е в начина, по който подава tools/context. При мен compact Tool Search конкретно пречеше и на нормалното директно exec, така че го изключих (tools.toolSearch=false) и разреших exec директно за модела. След това поведението стана доста по-нормално. Така, че прегледайте настройките преди да тествате особено ако го закачите за скъп модел.....😈

От снощи го въртя през OpenRouter с 3 модела на fallback и там вече стана доста по-интересно. Дадох му няколко доста тежки задачи по реален проект — да обходи цялото състояние на един полузавършен сайт на Pi-то, backend, frontend, engines, tests, assets и стари checkpoints; после отделно да направи forensic анализ кое е готово, кое е частично и кое липсва; след това implementation-readiness анализ кое от наличното реално може да се върже обратно в сайта. До момента с тези задачи се справи изненадващо добре и най-важното — изпълнява ги директно на Pi-то, а не аз да му копирам файлове един по един.

Засега обаче основно съм го тествал като autonomous research/terminal agent, не като Codex заместител за писане на код. Точно следващата задача вече е такава — ще му дам да направи backup и после реално да интегрира готов UI/functionality от стар checkpoint в текущия сайт, без да пипа работещите части. Та след нея вече ще мога по-смислено да кажа дали „усещането е като Codex“ и най-вече дали може да му се има доверие по кода 😄

Иначе големият плюс засега е, че Pi-то си работи самостоятелно — мога да затворя компютъра и агентът да си върши задачата там. Ще го оставя няколко дни да го тормозя и ще пиша как се държи при реална работа, не само на demo prompts.

Чакам да кажеш - как е с реални задачи...

Това с горенето на токени - така и не успяха да го оправят за токените явно и преди беше така и затова Антропик го баннаха от ползване с събскрипшън

Освен да питам пробвал ли си Хермес и безплатните модели към него :)
 
Чакам да кажеш - как е с реални задачи...

Това с горенето на токени - така и не успяха да го оправят за токените явно и преди беше така и затова Антропик го баннаха от ползване с събскрипшън

Освен да питам пробвал ли си Хермес и безплатните модели към него :)
За одити се справи супер, но с реалните задачи нищо не стана заради изгърмелите лимити. Ще тествам веднага след като се ресетнат. Ще пробвам и Хермес.

Като цяло не ми остава време за проучване защото от цикъла ходене на работа, проекта ми за Edge AI в свободното време за 2-3 часа реално трябва да отбия от едно от двете време за да бъзикам модели и апове.
 
Тъкмо ще споделиш от първа ръка усещало ли се като Кодекс
Разбрах откъде идва това усещане като Codex....
Как няма да има усещане като Codex, след като има официален Codex harness и реално работи през Codex app-server. 🤣 🤣 🤣
Аз както ти казах го тествах със стандартния OpenClaw runtime и различни модели от Groq/OpenRouter си викам чакай да ровна и се оказа доста буквално — OpenClaw си има режим, в който отдолу работи Codex......
 
OpenClaw е AI агентна платформа — не самият AI.
Тя свързва AI модел (мозъка — GPT, Claude и др.) с реални инструменти и компютър, за да може моделът не само да ти отговаря, а да изпълнява задачи: да пише/променя код, работи с терминал, файлове, браузър и т.н.

че то само така работи - дали ще е кодекс или друго аи.
 
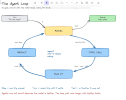
Харнеса си има специфика как точно луупва с какви инстументи разполага и от това също зависи какво се получава като краен резултат...

Всеки харнес си е специфичен ... Ако твърденията от тубата са верни - най точно съвпадение на усещането с Codex би било с GPT модел... НО ако луупа и инстументите вътре в OpenClaw са донякъде подобни или идентични с Кодекс - с друг достатъчно умен модел усещането за крайния резултат трябва да е донякъде подобно на Кодекс... Аз не мога да го кажа това дали е така, но който пише с Codex трябва да може да го предцени дали е близло или не ... дори и като се работи с различен от GPT модел ... Ако e близко - ще ви реши проблема на свършилите лимити.... Пишете си с GPT през OpenClaw, като свъши сменяте модела продължавате


Screenshot from 2026-09-04 21-46-33.png


Screenshot from 2026-09-04 21-45-42.png


видеото е за DeepSeek Harness, но обяснява много неща за харнесите по принцип...
 
Ето ти моя:

HOME AI / EDGE-AI LAB

Cloud intelligence
├── ChatGPT
├── Codex
└── други model/API backends

Engineering / orchestration
├── GitHub
├── repositories + checkpoints
├── agent workflows
├── automated validation
└── experiment/evidence tracking

Local compute
├── Raspberry Pi 5
│ ├── Hailo-8 AI accelerator
│ ├── local inference
│ ├── computer vision
│ └── sensor/camera processing
│
├── Raspberry Pi 4
│ ├── local AI/agent runtime
│ ├── local models
│ └── autonomous background work
│
└── Windows workstation
├── development
├── simulation/testing
└── AI-agent coordination

Physical AI / Edge
├── cameras
├── sensors
├── embedded systems
├── ESP32
└── real-world experiments
 

Цената за Европ 7799 евро 192GB RAM ползволяват да се рънне Qwen3.8 Flash Next във FP8 /Q8 качество или GLM 5.3 Flash
UD-IQ4_XS 157 GB

 
1791890175605.webp

Върховният AI суперкомпютър​

Базиран на NVIDIA DGX™ Station​

ASUS ExpertCenter Pro ET900N G3 е част от нов клас настолни AI суперкомпютри. Проектирана от самото начало за създаване и изпълнение на AI, тази революционна система отключва NVIDIA® GB300 Grace Blackwell Ultra Desktop Superchip и до внушителните 748GB голяма кохерентна памет. Способна да разработва и изпълнява мащабни AI натоварвания за обучение и инференция, тази настолна система използва NVIDIA® AI Software Stack, за да постави безпрецедентно количество изчислителна мощ в ръцете на AI екипите за разработка.
  • Логото на NVIDIA

    NVIDIA® GB300 Grace Blackwell Ultra Desktop Superchip
  • До

    748 GB

    кохерентна памет
  • До

    20 PFLOPS

    AI производителност
  • NVIDIA AI Software Stack
  • NVIDIA
    NVLink™-C2C

    NVIDIA NVLink-C2C разширява водещата в индустрията технология NVLink до чип-към-чип свързаност между GPU и CPU, позволявайки кохерентен трансфер на данни с висока пропускателна способност между процесори и ускорители.
  • Оптимизиран дизайн за охлаждане
  • NVIDIA ConnectX®-8 SuperNIC

    Значително подобрява производителността на системата за AI фабрики.

  • Характеристики

    Технологични пробиви​


    NVIDIA Grace Blackwell Ultra Desktop Superchip​

    Включва NVIDIA Blackwell Ultra GPU с най-новото поколение NVIDIA CUDA® ядра и Tensor Cores от пето поколение, свързани към високопроизводителен NVIDIA Grace CPU чрез NVIDIA® NVLink®-C2C interconnect, осигурявайки водеща в класа комуникация и производителност на системата.

    Tensor Cores от пето поколение​

    Задвижвани от най-новото поколение NVIDIA Blackwell Tensor Cores, които позволяват 4-битова плаваща запетая (FP4) за AI. FP4 увеличава производителността и размера на следващото поколение модели, които паметта може да поддържа, като същевременно запазва висока точност.

    NVIDIA ConnectX-8 SuperNIC​

    NVIDIA ConnectX®-8 SuperNIC е оптимизиран да ускори хипермащабируемите AI изчислителни натоварвания. С до 800 гигабита в секунда (Gb/s), NVIDIA ConnectX®-8 SuperNIC осигурява изключително бърза и ефективна мрежова свързаност, значително подобрявайки производителността на системата за AI фабрики.

    NVIDIA DGX OS​

    NVIDIA DGX OS предоставя стабилни, напълно сертифицирани операционни системи за изпълнение на AI, машинно обучение и аналитични приложения на платформата NVIDIA DGX. Той включва специфични за системата конфигурации, драйвери, както и диагностични и мониторинг инструменти. Лесно мащабирайте през множество системи NVIDIA DGX Station, NVIDIA DGX Cloud или друга ускорена инфраструктура за центрове за данни или облак.

    NVIDIA NVLink-C2C Interconnect​

    NVIDIA NVLink-C2C разширява водещата в индустрията технология NVLink до чип-към-чип свързаност между GPU и CPU, позволявайки кохерентен трансфер на данни с висока пропускателна способност между процесори и ускорители.

    Голяма кохерентна памет за AI​

    AI моделите продължават да растат по мащаб и сложност. Обучението и изпълнението на тези модели в голямата кохерентна памет на NVIDIA Grace Blackwell Ultra позволява модели от огромен мащаб да бъдат обучавани и стартирани ефективно в един общ пул памет, благодарение на C2C superchip interconnect, който заобикаля тесните места на традиционните CPU и GPU системи.

    NVIDIA AI Software Stack​

    Пълно стек решение за AI натоварвания, включително дообучаване, инференция и data science. Софтуерният стек за AI на NVIDIA ви позволява да работите локално и лесно да разгръщате към облак или център за данни, използвайки едни и същи инструменти, библиотеки, рамки и предварително обучени модели от настолна система до облак.

    Оптимизирано пренасочване на захранването според натоварването​

    NVIDIA DGX Stations използват AI-базирани системни оптимизации, които интелигентно пренасочват захранването според текущо активното натоварване, като непрекъснато максимизират производителността и ефективността.

    NVIDIA Multi-Instance GPU (MIG)​

    DGX Station поддържа технологията NVIDIA Multi-Instance GPU (MIG), за да разделя GPU на до седем инстанции за локална разработка с множество потребители, всяка напълно изолирана със собствена високоскоростна памет, кеш и изчислителни ядра.
 
С Mac Studio M5 Ultra 96 RAM подкарваш спокойно 32B, 70B дори 100B+ параметъра. Използвам съм го и се доближава доста до скоростта на Claude моделите. С една такава машина за 6к можеш да спреш да плащаш по 200 долара на месец и да си вършиш чудесно работата. Разбира се ако тя е свързана с ежедневно използване на AI. Ще се избие бързо, аз на macbook pro подкарвам доста добри модели а това направо е чук.
 
@coolice дай базата данни на форума на локалния AI да извади връзките между акаунтите - кои акаунт са от един и същ човек.
И да видим кой има най-много.
 
@coolice дай базата данни на форума на локалния AI да извади връзките между акаунтите - кои акаунт са от един и същ човек.
И да видим кой има най-много.

В някой неща не е хубаво да се дълбае ... Колкото толкова сега :) Всеки който е бил анти аи може да докара един нов клон и да почне да билдва проекти с АИ и да се не се притеснява за предишната си репутация :)


Иначе по темата излязоха RTX лаптопите DGX Spark цената продължава да е нагоре 7150 евро някъде в която зона ако нямате устройство може сериозно да се замислите за АМД с 192ГБ рам 7700 цена за Eвропа или mac studio с 256ГБ рам 10900 евро ще даде достъп в по големи модели в приемлив quant


Най големия който може да се рънне в приемлив quant q4 / fp4 на 1 Spark e Qwen3.8 Flash Next същия защото е МОЕ може да се рънне и на видеокарта с offload в рам и да се постигне приемлива скорост на 1500 евров сетъп с карта втора ръка


Горе