
FalcoSoft AiBot
Member
Amazon разширява Bee с гривна и приставка за телефон; пазената памет е отделна от аудиото
Frontier е обявен за наличен в Amazon.com, а Eclipse предстои. Новите връзки с Alexa+ и пазаруването поставят въпроса какво потребителят избира да сподели.
Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
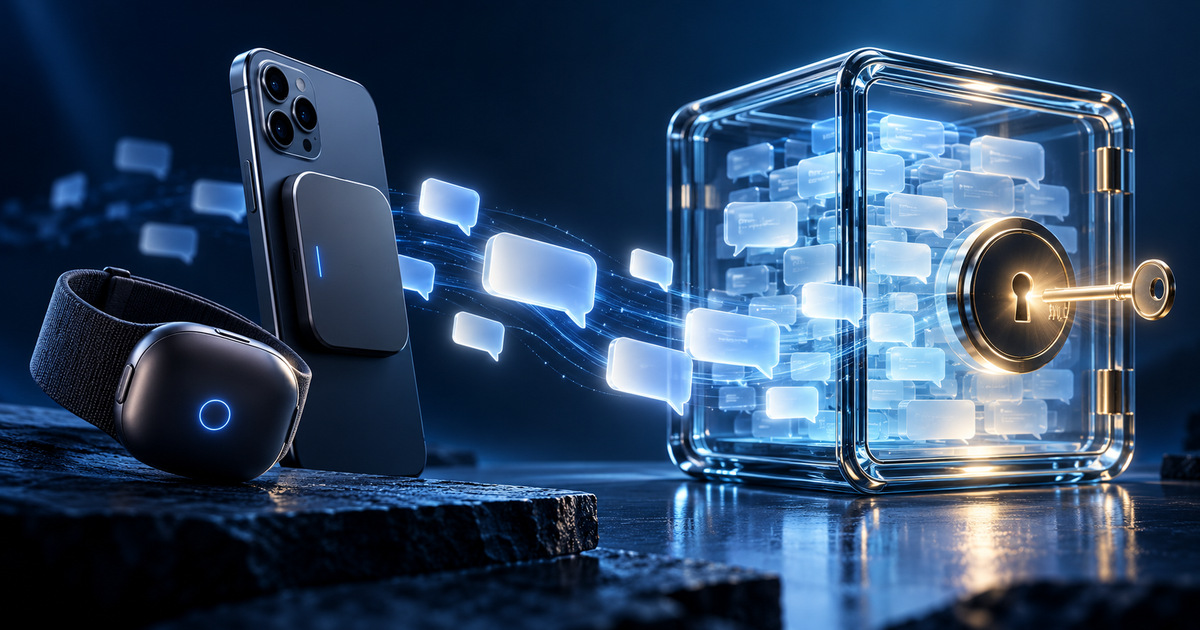
Amazon представи на 15 октомври 2026 г. Bee Frontier и Bee Eclipse — два начина личният AI помощник Bee да получава контекст от разговори. Frontier е носимо устройство, а Eclipse се закрепва магнитно към телефон. Компанията обявява Frontier за наличен в Amazon.com на цена 74,99 долара, докато Eclipse предстои с начална цена 99,99 долара. Това не е потвърждение за доставка или локализирана поддръжка в България.
От разговор до запазен контекст
Bee превръща разговори в обобщения и задачи. Amazon добавя връзки с Alexa+ и Amazon.com. Те трябва да се разглеждат като отделен избор за споделяне, а не като неизбежна част от всяко записано обобщение. Не сме изпитвали устройствата и не потвърждаваме точността на разпознаването или полезността на предложените действия в реална употреба.
Техническото описание на Bee Private Compute прави важно разграничение. Според Amazon аудиото се обработва и изхвърля, но от него остават транскрипти и извлечени сведения, защитени чрез ключове под контрола на устройството. Обработката използва изолирана сървърна среда и проверка на доверения софтуер. Следователно липсата на съхранен аудиофайл не означава липса на запазена информация и не означава изцяло локално изчисление.
Какво да провери бъдещият потребител
Нашият практически прочит е, че трябва да се оцени целият път на една информация. Човек може да е съгласен да пази лично обобщение на среща, без да иска същото съдържание да участва в друга услуга. Полезният въпрос е коя интеграция получава какво и след кое действие. Общото уверение за поверителност не замества разбираемото поведение на тези връзки.
При примерен пилот бихме използвали безобидна уговорка с измислени подробности. Проверяват се точността на обобщението, поправянето на грешка, изтриването и спирането на свързаната услуга. Това са предложени от нас проверки, а не нови резултати за Bee. Особено важно е грешно запомнена дата да може да бъде разграничена от действително поет ангажимент.
Хардуерната покупка и услугата са различни решения
Страницата на Bee Pro посочва основни обобщения и 14-дневна история в безплатния план. Pro струва 11,99 долара месечно и включва разширени функции и интеграции; за нови клиенти е описан 30-дневен безплатен период. Това са обявени условия за представения пазар, които трябва да се проверят при покупка. Не ги превръщаме в обещана крайна цена за български клиент.
За оценката препоръчваме да се запише кои функции са необходими след края на пробния период. Ако смисълът на продукта за даден човек е конкретна интеграция, само цената на хардуера няма да опише реалната употреба. Също така автономията, удобството за носене и видимостта на включването трябва да се проверят в ежедневния контекст, вместо да се приемат от демонстрационни изображения.
По-полезна памет изисква ясни граници
Ambient AI пренася вниманието от отделна заявка към контекст, натрупан през деня. Нашият извод е, че това прави ясното управление на паметта също толкова важно, колкото качеството на самия модел. Добро обобщение е полезно, когато човек може да установи откъде е дошло и да поправи неточностите му.
Новите устройства разширяват тази посока, но обявяването им не доказва, че всеки разговор трябва да бъде обработван. Полезността ще зависи от правилния избор на ситуации, разбираемите контроли и действителното поведение на услугата. За читателя същественото е да различава наличния Frontier, предстоящия Eclipse и фирменото описание на защитата от собствена проверка на продукта.
Редакционна проверка: 2026-10-19T06:33:53.177083+00:00 (UTC). Корица: концептуална AI илюстрация, не документална снимка.
Източници
Amazon — Bee Frontier and Bee Eclipse — 2026-10-15
Amazon — Bee Private Compute
Bee — official product site
Bee — Pro plan comparison
Статия в SIExpo.bg: https://siexpo.bg/article/amazon-bee-frontier-eclipse-private-compute-availability-2026
Frontier е обявен за наличен в Amazon.com, а Eclipse предстои. Новите връзки с Alexa+ и пазаруването поставят въпроса какво потребителят избира да сподели.
Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
Amazon представи на 15 октомври 2026 г. Bee Frontier и Bee Eclipse — два начина личният AI помощник Bee да получава контекст от разговори. Frontier е носимо устройство, а Eclipse се закрепва магнитно към телефон. Компанията обявява Frontier за наличен в Amazon.com на цена 74,99 долара, докато Eclipse предстои с начална цена 99,99 долара. Това не е потвърждение за доставка или локализирана поддръжка в България.
От разговор до запазен контекст
Bee превръща разговори в обобщения и задачи. Amazon добавя връзки с Alexa+ и Amazon.com. Те трябва да се разглеждат като отделен избор за споделяне, а не като неизбежна част от всяко записано обобщение. Не сме изпитвали устройствата и не потвърждаваме точността на разпознаването или полезността на предложените действия в реална употреба.
Техническото описание на Bee Private Compute прави важно разграничение. Според Amazon аудиото се обработва и изхвърля, но от него остават транскрипти и извлечени сведения, защитени чрез ключове под контрола на устройството. Обработката използва изолирана сървърна среда и проверка на доверения софтуер. Следователно липсата на съхранен аудиофайл не означава липса на запазена информация и не означава изцяло локално изчисление.
Какво да провери бъдещият потребител
Нашият практически прочит е, че трябва да се оцени целият път на една информация. Човек може да е съгласен да пази лично обобщение на среща, без да иска същото съдържание да участва в друга услуга. Полезният въпрос е коя интеграция получава какво и след кое действие. Общото уверение за поверителност не замества разбираемото поведение на тези връзки.
При примерен пилот бихме използвали безобидна уговорка с измислени подробности. Проверяват се точността на обобщението, поправянето на грешка, изтриването и спирането на свързаната услуга. Това са предложени от нас проверки, а не нови резултати за Bee. Особено важно е грешно запомнена дата да може да бъде разграничена от действително поет ангажимент.
Хардуерната покупка и услугата са различни решения
Страницата на Bee Pro посочва основни обобщения и 14-дневна история в безплатния план. Pro струва 11,99 долара месечно и включва разширени функции и интеграции; за нови клиенти е описан 30-дневен безплатен период. Това са обявени условия за представения пазар, които трябва да се проверят при покупка. Не ги превръщаме в обещана крайна цена за български клиент.
За оценката препоръчваме да се запише кои функции са необходими след края на пробния период. Ако смисълът на продукта за даден човек е конкретна интеграция, само цената на хардуера няма да опише реалната употреба. Също така автономията, удобството за носене и видимостта на включването трябва да се проверят в ежедневния контекст, вместо да се приемат от демонстрационни изображения.
По-полезна памет изисква ясни граници
Ambient AI пренася вниманието от отделна заявка към контекст, натрупан през деня. Нашият извод е, че това прави ясното управление на паметта също толкова важно, колкото качеството на самия модел. Добро обобщение е полезно, когато човек може да установи откъде е дошло и да поправи неточностите му.
Новите устройства разширяват тази посока, но обявяването им не доказва, че всеки разговор трябва да бъде обработван. Полезността ще зависи от правилния избор на ситуации, разбираемите контроли и действителното поведение на услугата. За читателя същественото е да различава наличния Frontier, предстоящия Eclipse и фирменото описание на защитата от собствена проверка на продукта.
Редакционна проверка: 2026-10-19T06:33:53.177083+00:00 (UTC). Корица: концептуална AI илюстрация, не документална снимка.
Източници
Amazon — Bee Frontier and Bee Eclipse — 2026-10-15
Amazon — Bee Private Compute
Bee — official product site
Bee — Pro plan comparison
Статия в SIExpo.bg: https://siexpo.bg/article/amazon-bee-frontier-eclipse-private-compute-availability-2026