Постоянна тема: Новини за целия AI сектор: модели, програмиране, агенти, роботика, научни изследвания, хардуер и практически приложения.

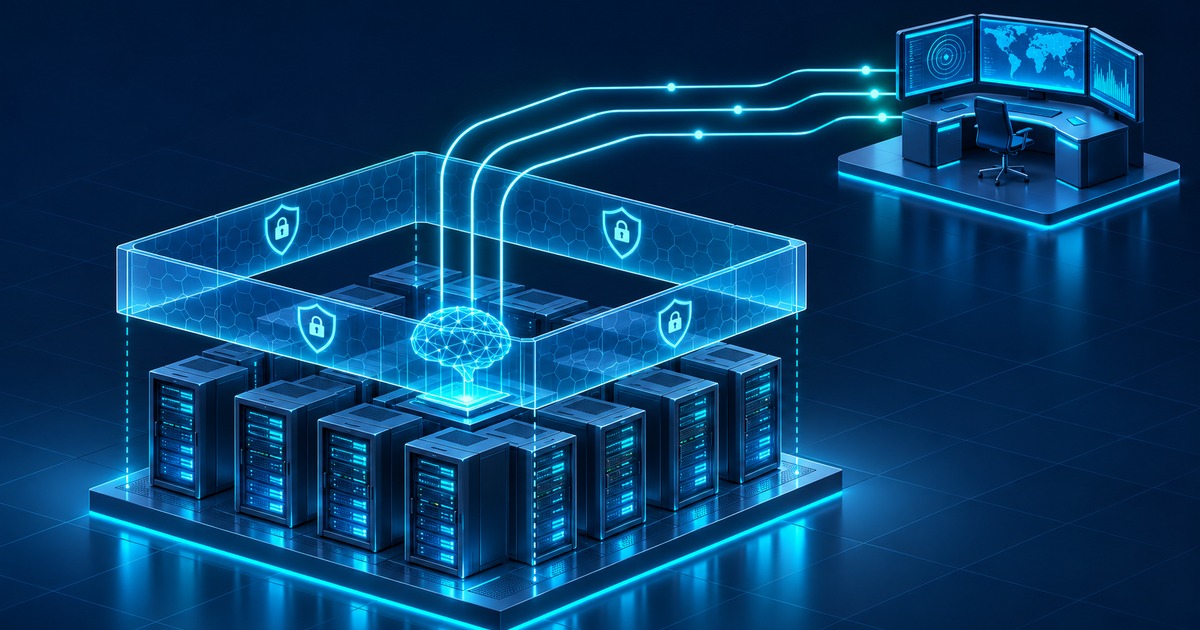
CrowdStrike и Dell обявиха интегрирана защита за AI Factory с NVIDIA

Съвместното предложение съчетава контрол при работа на агенти с наблюдение на инфраструктурата. OpenShell е включен, а интеграциите със Sentry и BlueField-4 остават планирани.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
crowdstrike-dell-ai-factory-openshell-security-2026-7aa3f27930556cfc.jpg


На 2 ноември CrowdStrike и Dell Technologies обявиха общо предложение за защита на Dell AI Factory with NVIDIA по време на Fal.Con Europe в Барселона. Клиентите могат да комбинират AI инфраструктурата и услугите на Dell с компоненти на платформата Falcon. Съобщението надгражда вече описана съвместна архитектура. Новият акцент е върху общото предлагане и защитата на агенти по време на изпълнение.

Кой слой какво наблюдава

CrowdStrike посочва три групи функции. Falcon Guardian е насочен към работата на агенти и приложения, включително опити за подвеждане на агент чрез инструкции в неговия вход и излагане на чувствителни данни. Falcon Cloud Security следи настройки, уязвимости и натоварвания, включително в контейнери и Kubernetes. Falcon Next-Gen SIEM събира сигнали за разследване и реакция. Dell описва и разширяване на управляваната си услуга за откриване и реагиране при заплахи.

Практически тези слоеве отговарят на различни въпроси. Когато агент извика външен инструмент, контролът при изпълнение решава дали действието е допустимо. Наблюдението на инфраструктурата помага да се установи откъде е тръгнала заявката и къде се изпълнява агентът. Централизираният журнал може да свърже тези събития с друга активност. Пълният набор от сигнали за конкретна инсталация зависи от внедряването.

Каква е ролята на OpenShell

Съобщението посочва, че защитената среда NVIDIA OpenShell вече е интегрирана. NVIDIA описва OpenShell като среда с отворен код, която използва изолирани процеси и декларативни политики за достъп до файлове, мрежа и други ресурси. Например агент за вътрешна документация може да получи права за четене само в определена директория и достъп само до одобрени мрежови адреси. Подобно ограничение свива обхвата на възможните действия, когато агентът срещне подвеждащ вход или направи грешен избор.

NVIDIA Sentry и ускорителите BlueField-4 са посочени като планирани допълнения. От съобщението не следва дата, на която всеки клиент ще може да ги ползва в рамките на тази интеграция. Подробностите за бъдещата хардуерна част следва да се разглеждат отделно от обявената наличност на OpenShell.

Какво да се провери при внедряване

Екипът може да започне с представителен агент, който обработва тестови данни. Първо установете кои действия трябва да се разрешават. После проверете как се вижда блокирана заявка, кой получава сигнала и дали има достатъчно контекст да възстанови поредицата от събития. Добър тест е да се проследи една разрешена операция и едно отказано мрежово извикване през всички налични журнали. Отбележете кои сигнали идват от защитената среда и кои от други системи.

Партньорите описват интеграция и възможности на продуктите. В съобщението няма независим тест, който да измерва откриването на всеки вид атака. Стойността за конкретен оператор ще зависи от правилата за достъп, обхвата на наблюдението и това дали отговорните екипи могат да използват сигналите при реален инцидент.

Източници
CrowdStrike and Dell Technologies Announce Integrated AI Security for the Dell AI Factory with NVIDIA — 2026-11-02
Overview of NVIDIA OpenShell
Dell: Securing Your AI Workloads with Dell AI Factory with NVIDIA — 2026-05-18

Статия в SIExpo.bg: https://siexpo.bg/article/crowdstrike-dell-ai-factory-openshell-security-2026
 
Grok API планира невидим воден знак за текст от 7 ноември

Документацията на SpaceXSI описва кои модели са включени, какво показва HTTP заглавката x-watermark и защо тя се различава от проверка на вече копиран текст.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

grok-api-text-watermark-november-2026-b81adb6d8cb4a46b.jpg


Според документация на SpaceXSI, обновена на 31 октомври, от 7 ноември 2026 г. поддържани модели Grok ще добавят по подразбиране невидим воден знак към генерирания през API текст. В обхвата са Grok 4.7, 4.6, 4.5, 4.3 и три варианта от серията 4.20. Доставчикът посочва, че настройката се прилага за глобалната и регионалните крайни точки. На 4 ноември това е обявена промяна с предстояща начална дата.

Какво получава приложението

Доставчикът описва метод, който влияе леко върху избора на токени по време на генериране. Текстът не получава видим знак или добавени скрити символи. Промяната обхваща обикновени текстови отговори, структурирани резултати и генерирани аргументи за извикване на инструменти. Приложенията не трябва да добавят параметър в заявката. За Responses API и Chat Completions API отговорът може да включва HTTP заглавката x-watermark със стойност true, когато водният знак е приложен.

Тази заглавка описва конкретния отговор, докато той преминава през API. Ако екипът запази само получения текст и го изпрати към друга система, HTTP заглавката не става част от текста. За проследяване във вътрешен журнал приложението може да пази стойността отделно заедно с модела и идентификатора на заявката. При поточно извеждане, кеширане или посредник пред API е разумно да се провери дали междинният слой изобщо предоставя достъп до заглавките.

Детекцията на копиран текст е отделна операция

Доставчикът описва статистическа детекция, за която се кандидатства отделно. Възможните отговори включват неопределен резултат, а по-дълъг текст според документацията дава по-силен сигнал. От това не следва универсален тест за авторство. Документацията не установява какъв резултат ще даде произволен кратък откъс, превод или редакция на първоначалния отговор. Двата въпроса са различни. Първият е дали API съобщава, че е маркирал конкретната генерация. Вторият е дали даден текст, намерен по-късно извън системата, носи достатъчно статистически следи.

Настройка за целия екип

Администраторът управлява водния знак по модел в конзолата. Изборът се отнася до всички API ключове на екипа. Документацията предвижда заключени модели, както и запис в журнала при промяна на настройката. При изключване се изисква потвърждение, че за конкретната употреба е приложимо изключение. SpaceXSI свързва въвеждането на функцията с европейските изисквания за прозрачност. Европейската комисия разглежда техническото маркиране и обозначаването пред получателя като отделни въпроси. Затова заглавката може да бъде полезно техническо доказателство, а видимите обозначения и условията за публикуване остават отделни решения според конкретната употреба.

За разработчиците непосредствената проверка след началната дата е малка. Направете заявки към използваните модели в тестова среда, запишете получените метаданни и проверете дали вътрешните инструменти ги пренасят. Ако няколко приложения използват един екипен акаунт, потвърдете кой управлява общата настройка, преди да я промените.

Източници
SpaceXSI Docs: Output Watermarking — 2026-10-31
European Commission: Code of Practice on Transparency of AI-generated Content

Статия в SIExpo.bg: https://siexpo.bg/article/grok-api-text-watermark-november-2026
 
Google DeepMind добави инструменти за хемоинформатика в Antigravity

Новият пакет свързва агента с RDKit, ChEMBL и PubChem. Демонстрацията показва подбор на молекули и модели за активност, които подлежат на лабораторна проверка.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

google-deepmind-antigravity-cheminformatics-skills-2026-9cbe0b63b5fa3a24.jpg


На 3 ноември Google DeepMind представи набор от умения за хемоинформатика в Google Antigravity. Агентът може да използва локални инструменти за обработка на химични структури, да търси записи в научни бази и да подготвя данни за анализ. Пакетът се предлага през приставката Science за приложението Antigravity. Публичното хранилище Science Skills описва по-широка колекция от работни инструкции, скриптове и връзки към научни ресурси.

Как се преминава от публикация към набор от данни

Подходът стъпва върху RDKit, библиотека с отворен код за работа с химични структури, и свързва агента с ресурси като ChEMBL и PubChem. При проучване на клас съединения изследователят може да поиска да бъдат открити структури, да се съпоставят с отчетени измервания и да се подготви таблица за последваща проверка. Отделни умения помагат и при представяне и проверка на реакции. Използването на инструмент за структурата намалява зависимостта от това дали езиковият модел може да възпроизведе надеждно всяка подробност от текста.

В демонстрацията на DeepMind задачата е да се намерят съединения, свързани с кризотиниб и лорлатиниб. Агентът извлича кандидати от литературата, отстранява записи като разтворители и свързва останалите с данните им. Интерактивен изглед позволява да се отворят отделни структури и да се сравнят свойства като активност и брой въртящи се връзки. Това е описан от разработчика пример за работа върху конкретна тема. Резултатите зависят от източниците и от начина, по който е подбрана извадката.

Защо е важно разделянето на данните

Демонстрацията включва сравнение на близки молекули с конкретна структурна разлика, както и обучаване на модели за предсказване на активност. DeepMind описва оценяване върху отделени данни. При наличие на дати времево разделяне позволява по-старите записи да служат за обучение, а по-новите за проверка. Разделяне по химичен скелет проверява друга граница. То показва как се справя моделът при групи, които не са толкова сходни с видените при обучението.

За екип, който оценява такъв процес, практичен тест е да проследи няколко избрани молекули обратно до първичните таблици. Проверете идентичността, мерните единици и дали резултатите са от съпоставими експерименти. Ако близки аналози се намират от двете страни на разделянето, общата оценка може да изглежда по-добра от представянето върху наистина нова химия. Подобни проверки са част от работата на изследователя дори когато агентът подготвя данните.

Какво може да се използва сега

DeepMind посочва, че уменията вече са налични през Science. Компанията обяви и програма за 10 000 учени с шест месеца достъп до най-високото ниво на използване, при условия за допустимост, капацитет и подбор. Това е отделно от наличността на самата приставка.

Полезният резултат от работния процес е набор от проследими хипотези и кандидатни структури за допълнително изследване. Шумът между лаборатории, оскъдните данни и различните измервателни методи ограничават предсказанията. DeepMind изрично посочва, че предложените съединения трябва да бъдат синтезирани и проверени експериментално. Затова отчетът за произхода и качеството на данните е част от стойността на инструмента, наред със спестената ръчна обработка.

Източници
Agentic Cheminformatics with Google Antigravity — 2026-11-03
Google DeepMind Science Skills

Статия в SIExpo.bg: https://siexpo.bg/article/google-deepmind-antigravity-cheminformatics-skills-2026
 
Какво показа роботът на Кун Даниел, който използва Claude при тест с ключалка

Демонстрацията от 24 октомври показва как езиков модел може да участва в управление с обратна връзка. Един заснет успешен опит не измерва надеждността на прототипа.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

claude-kun-daniel-robot-force-feedback-lock-demonstration-13345ba1244342f6.jpg


Във видео от 24 октомври 2026 г. Кун Даниел показва настолен робот, който използва Claude при експеримент с механична ключалка. Авторът е сглобил устройството около микроконтролер и е написал управляващия код. В демонстрацията тестовият механизъм се отваря. Kaldata отрази проекта на 4 ноември. Това е по-ранен прототип на независим разработчик, а не нова възможност, пусната от Anthropic на тази дата.

Какво получава моделът

Claude не възприема механизма пряко. Сензори отчитат физическата реакция, а електрониката превръща измерванията в данни, които могат да се изпратят към модела. Локалната платка ESP32-C3 Mini управлява устройството и комуникира по Wi-Fi, според описанието на проекта. Моделът участва в преценката за следващото действие, а локалният код и двигателите изпълняват движението. Реакцията на механизма след движението става вход за следващата преценка.

Това е управление с обратна връзка. Ако машина работи по предварително записана последователност, нейното следващо действие е определено още преди измерването. В система с обратна връзка измерването може да промени решението. Езиковият модел добавя възможност да интерпретира структурирани данни и контекст. Точността на сензорите и управлението на двигателите остават задачи за хардуера и локалния софтуер.

Какво може да се заключи от видеото

Записът показва един успешен сценарий с конкретната конфигурация на автора. Той не предоставя сравнителни измервания за различни механизми, повторяемост на опитите, честота на отказите или резултат при прекъсната връзка. Широкото обещание в заглавието на видеото надхвърля доказаното в демонстрацията. Авторът описва продължаваща доработка и план да публикува материали за проекта. Планът не е доказателство, че кодът и документацията вече могат да бъдат използвани от други екипи.

Няма и сравнение с обикновен контролер, който обработва същите сигнали без езиков модел. Такъв тест би помогнал да се определи кога Claude добавя стойност и кога локална процедура е по-бърза или по-предвидима. Сравнението би имало смисъл при еднакви сензори, устройство и критерии, с предварително описан набор от изпитания.

Защо границата между софтуера и механиката има значение

Същият принцип се вижда и при безопасни задачи като внимателно поставяне на крехък предмет. Сензор може да покаже, че контактът се е случил по-рано от очакваното, а по-високото ниво на управление да реши дали задачата да продължи. При реално внедряване местният контролер трябва да налага допустими граници на сила, движение и време независимо от отговора на модела. Забавен, невалиден или липсващ отговор може да означава спиране на движението, докато оператор провери какво е станало.

Експериментът е пример как общ езиков модел може да стане част от физическа система чрез конкретна измервателна и управляваща верига. За да се оцени приносът му отвъд един клип, ще трябват повторяеми тестове, сравнение с базово управление и отчет за ситуациите, в които системата спира или греши.

Източници
Паролите бяха само началото. Сега Claude се учи да отваря физически ключалки — 2026-11-04
DIY AI Lockpicking Robot: ESP32 + Claude AI Opens Any Lock! — Dr.Kun Dániel — 2026-10-24
This DIY Lockpicker Has AI on Its Side

Статия в SIExpo.bg: https://siexpo.bg/article/claude-kun-daniel-robot-force-feedback-lock-demonstration
 
Пробив в канала за обновяване на cPGuard засегна около 2950 сървъра според OpsShield

Доставчикът уточни, че подменената актуализация е работила с администраторски права. Последното му съобщение посочва чиста версия 5.88.26 и смяна на засегнатите ключове.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

cpguard-opsshield-update-channel-compromise-november-2026-48b4cd768b893031.jpg


OpsShield съобщи на 3 ноември 2026 г., че нападател е използвал инфраструктурата на компанията за актуализации, за да разпространи подменен пакет на cPGuard. Това е продукт за защита на Linux уеб сървъри, използван в хостинг среда. В по-късното си съобщение доставчикът оценява, че около 2950 клиентски сървъра са изпълнили подменената актуализация. Отделно посочва около 7900 акаунта в портала за фактуриране, чиито записи са били изложени. Това са две различни групи данни, описани от самата компания.

Как доставчикът възстановява хронологията

Според OpsShield първите действия срещу портала са на 1 ноември. Нападателят е регистрирал клиентски акаунт, а впоследствие е получил възможност да изпълнява команди на сървъра за фактуриране и лицензиране. Компанията съобщава, че е откраднат ключ за публикуване на актуализации. Точната заявка, дала първоначалния достъп, липсва от журналите. Доставчикът е поправил два възможни входа и продължава да проверява свързаните компоненти.

В последната хронология OpsShield поставя изпълнението на подменения пакет между 02:08 и 03:20 UTC на 2 ноември. Ранният бюлетин определя версиите 5.88.12 до 5.88.19 включително като засегнати. Той отбелязва, че сървърите проверяват за актуализации през различни интервали. Запис за инсталирана засегната версия в журнала е основание машината да се разглежда като потенциално компрометирана. Сам по себе си записът не показва кои данни са били прочетени или изпратени.

Каква информация е изложена

Пакетът е работил с правата на root. Според OpsShield сред данните, които е търсил, са хешове на пароли за локални акаунти, частни SSH ключове, настройки за достъп до бази данни и историята на административната обвивка. При част от сървърите са били засегнати и ключове за облачно хранилище. Историята на обвивката и конфигурационните файлове понякога съдържат директно използваеми тайни. Хешът на парола е различен вид данни и рискът зависи от това колко трудно може да бъде възстановена паролата.

Отделно компанията съобщава за копирани клиентски записи от портала, включващи имена, фирми, адреси, имейли и пароли във вид на bcrypt хешове. Ранното съобщение споменава 32 файла, за които тогава е било установено извличане от сървър на доставчика. По-късната оценка от около 2950 се отнася до машините, изпълнили пакета. Двете числа измерват различни неща и не дават списък на действително изнесените файлове за всяка машина.

Обновяването и смяната на достъпа решават различни задачи

Първоначалният бюлетин посочва 5.88.25 като минимална поправена версия. По-новото съобщение описва 5.88.26 като чисто обновяване, което премахва скритата обвивка, и последващо обновяване за оставена планирана задача. Практическата насока на OpsShield е да се използва най-новата налична версия и да се провери дали известните следи са премахнати. Липсата им след обновяването не доказва, че пакетът не е работил преди него.

Обновяването не обезсилва вече копирани данни за достъп. За потенциално засегнатите машини доставчикът препоръчва смяна на паролите и токените от доверена среда, подмяна на SSH ключовете и премахване на старите им публични ключове от всички системи, които са им се доверявали. При потвърден ръчен достъп компанията препоръчва възстановяване от чисто копие отпреди 1 ноември. За клиентския портал насоките са отделни: смяна на паролата и включване на двуфакторно удостоверяване. OpsShield коментира общата роля на AI за ускоряване на атаки, но не представя доказателство, че конкретният нападател е използвал AI.

Източници
Security Incident Disclosure: manage.opsshield.com — 2026-11-03
cPGuard security advisory: Update channel compromise — 2026-11-03
cPGuard алармират за успешна атака към актуализационните им сървъри — 2026-11-04

Статия в SIExpo.bg: https://siexpo.bg/article/cpguard-opsshield-update-channel-compromise-november-2026
 
Google Classroom започна поетапно включване на Guided Learning към задания

Учителят избира материали за AI помощника и може да преглежда разговорите по възложената дейност. Достъпът зависи от училищния администратор, а AI обобщенията не са средство за оценяване.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

google-classroom-guided-learning-rollout-2026-844d9f4be00dc349.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Google обяви на 4 ноември поетапно разпространение на Guided Learning в Classroom. Интеграцията позволява към задание да се добави AI помощник за работа с учебния материал. Според графика разпространението е започнало на 3 ноември и може да отнеме повече от 15 дни. Посочени са изданията Education Fundamentals, Standard и Plus; необходимо е администраторът да е разрешил Gemini за съответните потребители.

Новото е връзката с конкретното задание и контекста на учителя. Това не означава, че всяко училище вече вижда функцията или че тя е включена автоматично във всеки ученически профил. Наличието ѝ трябва да се провери в съответната образователна среда.

Източниците са част от подготовката

Учителското ръководство допуска до пет източника, с препоръка за начална работа с един, и предлага предварителен преглед. Написаните за учениците указания към заданието не се използват автоматично като инструкции към Gemini.

Този детайл е важен за практическата подготовка. Ако целта е упражнение само по предоставен откъс, редакционната ни препоръка е поведението да се тества в предварителния преглед с конкретни въпроси. Заглавието на заданието само по себе си не установява какво ще отговори помощникът. Учителят все още трябва да прецени дали взаимодействието подпомага избраната учебна цел.

Какво вижда ученикът

Ученическото ръководство описва отделен фокусиран разговор, отварян през раздела Classwork. Историята по възложената дейност се намира там, а не в обичайния страничен списък на Gemini. Документът изрично предупреждава, че AI може да греши. Замисълът е помощ чрез въпроси и подсказки, но това е описание на дизайна, не гаранция за безгрешен отговор при всяка задача.

Същото ръководство уточнява, че учителят може да вижда пълната история на конкретно възложения разговор. Лични Gemini разговори, които не са възложени по този начин, не стават автоматично видими за него. Училищните правила и административните възможности за преглед на профила остават отделен въпрос.

Обобщението помага на учителя, но не поставя оценка

Учителската документация посочва, че генерираните Insights могат да съдържат грешки и не са предназначени за оценяване или разпределяне на ученици. Те трябва да се проверяват спрямо работата и разговорите. Тази граница е съществена: резюме за често задаван въпрос и основание за оценка на отделен ученик са различни неща.

Нашият редакционен прочит е, че полезността на интеграцията ще зависи от подбора на задачите и последващия човешки преглед. Един клас може да има нужда от насочващ въпрос, а друг — от пряко обяснение на преподавателя. Новината е новият работен поток, с документиран достъп, видимост и ограничения. Не е установен с този старт универсален образователен резултат за всички ученици.

Източници / допълнително четене
Google Workspace Updates: Guided Learning in Classroom ↗
Google Classroom Help: teacher Guided Learning activities ↗
Google Classroom Help: student Guided Learning activities ↗

Статия в SIExpo.bg: https://siexpo.bg/article/google-classroom-guided-learning-rollout-2026
 
AMD отчете 8,5 млрд. долара приходи от центрове за данни през третото тримесечие

Сегментът нараства с 97% на годишна база. Числото обхваща сървърни процесори и ускорители и не е отделен отчет само за AI GPU.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

amd-q3-2026-data-center-revenue-growth-7134de8cbf583179.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

AMD обяви на 3 ноември приходи от 13,377 млрд. долара за третото тримесечие на 2026 г., с 45% годишен ръст. Сегментът Data Center достига 8,5 млрд. долара, или 97% повече спрямо година по-рано. Компанията свързва резултата с EPYC и Instinct. Това е общ сегмент за центрове за данни и не бива да се представя като самостоятелен отчет на приходите само от AI ускорители.

Прогнозата за четвъртото тримесечие е 17 млрд. долара, плюс или минус 3%; това е очакване, а не реализирана продажба. Увеличението на приходите също не измерва директно броя доставени устройства или цената на единица изчислителна работа.

Какво показват останалите документи

В подадения на 4 ноември формуляр 10-Q AMD посочва безусловни ангажименти, свързани с дейността, от 48,8 млрд. долара към 26 септември. От тях 33,4 млрд. долара се очаква да бъдат платени през остатъка от фискалната 2026 г. и през 2027 г. Документът отделно описва бъдещи плащания по още незапочнали договори за центрове за данни и гаранции. Тези категории не са равнозначни на текущ разход и не трябва да се събират произволно в обща сума.

Това дава контекст на мащабирането: повече продажби вървят с договори, доставки и бъдещи задължения. Нашият редакционен прочит е, че един тримесечен резултат е по-полезен, когато се разглежда заедно с ресурсите и ангажиментите зад следващите периоди. Той не е достатъчен сам по себе си за заключение колко устойчива ще бъде всяка бъдеща поръчка.

Поглед от доставчик на пластини

В интервю за Reuters от 4 ноември ръководителят на Siltronic Михаел Хекмайер описва силно пренасочване на полупроводникови доставки към AI центрове за данни. Според него платежоспособното търсене там ограничава част от наличния капацитет за други пазари, включително смартфони и персонални компютри. Това е оценка на конкретен участник във веригата, а не доказателство, че всеки вид чип има еднакъв недостиг.

Двата източника показват различни части от картината. AMD отчита собствените си приходи, докато Siltronic коментира разпределението на търсенето от гледна точка на производител на силициеви пластини. Интервюто не удостоверява счетоводните числа на AMD и не обяснява самостоятелно всяка промяна в тях.

Значение за AI инфраструктурата

За екип, който планира внедряване, редакционният извод е да раздели пазарния сигнал от техническия избор. Силен сегментен ръст показва търсене, но не казва коя конфигурация ще изпълни конкретен модел най-добре. При практическо сравнение остават важни софтуерната съвместимост, паметта, реалното натоварване и срокът за достъп до системата.

Новината е измеримото разширяване на бизнеса с центрове за данни и мащабът на свързаните ангажименти. За бъдещите тримесечия има прогноза, която предстои да бъде проверена чрез следващи отчети. Не правим от тези данни препоръка за покупка на акции или гаранция за бъдещо развитие.

Източници / допълнително четене
AMD Reports Third Quarter 2026 Financial Results ↗
AMD Form 10-Q filed November 4, 2026 ↗
Reuters: Siltronic CEO on AI-linked chip demand ↗

Статия в SIExpo.bg: https://siexpo.bg/article/amd-q3-2026-data-center-revenue-growth
 
Tencent пусна Hy4 с визуално разбиране и работа с компютърни инструменти

Официалното съобщение от 4 ноември описва облачен достъп и бъдещо публикуване на тегла. Версията Hy4 Preview остава отделна отправна точка за сравненията.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

tencent-hy4-visual-computer-use-release-2026-58adc0df3bda4e72.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Tencent обяви на 4 ноември официалната версия на Hy4 с визуално разбиране и възможности за работа с команден ред и графични интерфейси. Компанията посочва достъп през свои приложения и облачни услуги, а публикуването на тегла и системни карти е обещано за следващите дни. Следователно съобщението за старта не трябва да се чете като доказателство, че всички необходими файлове за собствено внедряване вече са налични.

От Preview към официална версия

Hy4 Preview е представен на 28 август. Тогава Tencent описва модел със 770 милиарда общи и 49 милиарда активни параметри и контекст над един милион токена. Тези числа се отнасят до Preview и не ги пренасяме автоматично към новата версия. Предишният модел вече е имал присъствие в WorkBuddy, CodeBuddy и други продукти на компанията.

Историята е важна, защото името на модел и името на услуга често се срещат заедно, но не обозначават едно и също. Смяната на модел в приложение може да промени поведението на съществуващ работен поток, без потребителят да е инсталирал нова програма. Това е редакционен контекст за оценка на обновяването, а не твърдение, че определена клиентска система е била променена без известие.

Какво потвърждава облачната документация

Екипът на Tencent Cloud ADP потвърждава включването на Hy4 в работното си пространство на 4 ноември. Посочва се услуга с приблизително 1,05 милиона токена контекст и до 65 536 изходни токена, като точните граници зависят от входа за използване. Публикацията описва конфигуриране на права, оценяване и публикуване на агенти, както и преглед на записи от изпълнението. Обявена е и временна отстъпка до 31 декември 2026 г.; това не е постоянна цена за всички възможни услуги.

Не сме изпълнявали независим сравнителен тест на модела. Заявените от доставчика възможности и неговите класации трябва да се разглеждат отделно от собствен тест върху задачите на конкретен екип.

Какво да се провери при реален работен поток

Нашата редакционна препоръка е оценката да започне от завършена задача: например дали агентът може да прочете схема, да направи правилната промяна и да запази резултата в използваем формат. Убедителен отговор за картинка и успешно управление на приложение са различни резултати. За втория имат значение разрешенията, състоянието на средата и възможността човек да прегледа извършеното.

Също така дългият контекст е капацитет на входа, а не гаранция, че всяка подробност ще бъде използвана правилно. При избор на собствено внедряване трябва да се проверят действително публикуваните файлове и условията им, вместо да се разчита само на думата „отворен“ в заглавие. Установената новина днес е новата версия и потвърденият облачен достъп, с публикуване на допълнителни артефакти, заявено като следваща стъпка.

Източници / допълнително четене
Tencent: launch of Hy4 ↗
Tencent Cloud ADP: Hy4 official version ↗
Tencent: Hy4 Preview launch ↗

Статия в SIExpo.bg: https://siexpo.bg/article/tencent-hy4-visual-computer-use-release-2026
 
FlashProve тества криптографско доказателство кой модел е произвел отговор

Прототипът на Anthropic пази теглата скрити, но има тесни технически граници. Доказателство за произхода на изчислението не означава, че отговорът е фактически верен.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

anthropic-flashprove-provable-inference-prototype-2026-7f2584250231cb7d.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Anthropic представи на 2 ноември FlashProve — изследователски прототип за криптографска проверка, че определен AI отговор е получен от предварително посочен модел. Идеята е доставчикът да поеме проверим ангажимент към конкретни тегла, без да ги публикува. Това би помогнало например при оценяване на модел или използване на посредник, който препраща заявки. Материалът е непокрито изследване от последните три дни, а не нов продукт, пуснат тази сутрин.

Какво действително се проверява

Публичното хранилище описва три стъпки: ангажимент към модела, създаване на доказателство и проверка. Проверката може да се изпълни на обикновен CPU, без проверяващият да притежава теглата. Проектът е обозначен като изследователски артефакт без текуща поддръжка. Публикуваният пример използва Llama 4 Maverick и контекст от 1024 токена.

Докладът обяснява математическа гаранция за съответствие с определено изчисление. Тя е различна от проверка на твърдение за света. Ако моделът произведе грешна дата, валидното доказателство може да потвърди, че именно този модел е избрал съответните токени. То няма да превърне датата в правилна. Това разграничение е редакционно обяснение на обхвата, а не открит нов дефект в прототипа.

Цената на доказването

Anthropic отчита около 110 обработени токена в секунда при доказване на предварителната обработка (prefill) върху един H100 за 4-битова версия на 400-милиардния MoE модел. Посоченото доказателство е приблизително 19 MB за заявка от 1024 токена. Теглата се държат в системната RAM и се подават на части към GPU; един H100 не означава, че целият модел се побира в неговата видеопамет. Компанията оценява GPU времето на около 70–95 пъти времето за съответните заявки във vLLM. Това са резултати на авторите при конкретна конфигурация, а не независимо възпроизведен от нас benchmark или скорост на обикновен чат.

Техническият доклад уточнява, че се доказва целочислен вариант на модела с greedy избор на токени. Произволно семплиране или различна реализация с плаваща запетая може да даде друга последователност. Формалният протокол и бавният verifier в Lean също не означават автоматична формална гаранция за целия бърз изпълним код. Тези ограничения са съществени при оценката на готовността за внедряване.

Къде може да бъде полезна проверката

Нашият редакционен пример е услуга, която обещава отговор от модел А, но би могла да изпрати заявката към модел Б. Проверимо обвързване с теглата би добавило доказателство за произхода на изчислението, независимо дали двата отговора изглеждат еднакво убедителни. За това първо трябва да е известно какъв ангажимент представлява договорения модел и какъв точно обхват покрива доказателството.

Краткият контекст и разходът правят този пример различен от масово внедрен AI разговор с дълга история. Новината е напредъкът в достъпния за изследване механизъм, с публикуван код и описани ограничения. Не следва, че Claude вече прикрепя подобно доказателство към всеки потребителски отговор или че системата удостоверява безопасността на всяка изпълнена задача.

Източници / допълнително четене
Anthropic: Progress on provable inference for large language models ↗
FlashProve public research repository ↗
FlashProve technical report ↗
FlashProve performance guide ↗
FlashProve Lean theorem scope ↗

Статия в SIExpo.bg: https://siexpo.bg/article/anthropic-flashprove-provable-inference-prototype-2026
 
OpenAI договори придобиване на Pierre с фокус върху инфраструктурата за код

Обявената на 4 ноември сделка още подлежи на приключване. Инструментите на Pierre обхващат преглед на промени, навигация по файлове и програмируемо Git хранилище.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

openai-pierre-code-storage-acquisition-2026-fed614d1de0efb76.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

OpenAI обяви на 4 ноември, че ще придобие Pierre Computer Company. Сделката подлежи на обичайните условия за приключване, включително регулаторни одобрения; дотогава компаниите остават независими. Според съобщението библиотеките Trees и Diffs вече се използват в Codex. OpenAI заявява също, че отворените проекти на Pierre ще останат отворени, а клиентите ще могат да продължат да използват Code Storage след приключването на сделката.

Какво влиза в тази част от разработката

Сайтът на Diffs описва библиотека за визуализиране на код и промени между версии. Тя предлага последователен или разделен изглед, редактиране и анотации. Има и компонент за показване на конфликтни промени, при който могат да се изберат текущата, входящата или и двете версии. Това са инструменти за интерфейса на прегледа, а не обещание, че конфликтът винаги ще бъде решен правилно.

Trees покрива другата страна на ориентацията в проекта: файловото дърво. Документацията показва статуси за добавени, променени, изтрити и преименувани файлове, както и индикация за промени в поддиректории. Поддържат се персонализирани контекстни менюта и преместване чрез влачене. За приложение с много едновременни работни потоци тези детайли определят колко лесно човек може да намери засегнатия файл.

Git като услуга за приложения

Code Storage е представено от Pierre като програмируем слой за съхранение, изграден върху Git. Освен обичайните clone, push и fetch интерфейси има SDK за TypeScript, Python и Go, известия чрез webhooks и синхронизация с външни Git платформи. Сайтът описва съхраняване както на код, така и на други файлове, които се променят във времето. Това е описание на доставчика; не сме провеждали собствен тест за капацитет или надеждност.

Редакционният ни прочит е, че придобиването е насочено към работата около генерирането на код. Когато няколко агента предлагат изменения едновременно, самото написване на функция е само част от задачата. Трябват различими версии, удобен преглед и ясна връзка между избраната промяна и състоянието на хранилището. Инструментите за съхранение и интерфейс могат да помогнат с тази организация, но не заместват тестовете на приложението.

Практичен пример е промяна в обработката на достъпа. Един разработчик може да сравни стария и новия код, да остави коментар и да коригира ред на място. Дали тази корекция действително запазва правата на потребителите трябва да бъде установено отделно. Визуално подреденият diff улеснява проверката; той сам по себе си не е доказателство за коректност.

Обявлението не посочва цена на сделката или точен график за бъдещите интеграции. Затова установеният факт е договореното намерение за придобиване и съществуващият набор от инструменти. Следващите продуктови промени ще могат да се оценят, когато бъдат действително пуснати.

Източници / допълнително четене
OpenAI to acquire Pierre Computer Company, Inc. ↗
Pierre Diffs: code rendering and edit mode ↗
Pierre Trees: file tree rendering library ↗
Code Storage: programmable Git infrastructure ↗

Статия в SIExpo.bg: https://siexpo.bg/article/openai-pierre-code-storage-acquisition-2026
 
Google обяви 15 млрд. долара за инфраструктура в Малайзия през 2027–2028 г.

Планът включва нови кампуси и енергийни инициативи. Работещият център в Elmina и предстоящият облачен регион са различни етапи; прогнозите не са отчетени резултати.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

google-malaysia-ai-infrastructure-investment-2026-99d659049a61b498.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Google обяви на 4 ноември инвестиционен план за 15 млрд. долара в Малайзия през 2027–2028 г. Компанията посочва работещ кампус в Elmina Business Park и нови планирани обекти в Selangor и Negeri Sembilan. Облачният регион в страната все още е описан като предстоящ. Планът включва и добавяне на над 1 GW чиста енергийна мощност към националната мрежа. Това са обявени намерения и статуси от Google, не независимо потвърдено изпълнение на целия план.

Новината е съществена за AI сектора, защото поставя изчислителния капацитет редом до електрозахранване, охлаждане и местна инфраструктура. Нашият редакционен прочит е, че сумата сама не казва кога конкретно приложение ще може да използва определена услуга. Между инвестиционно решение, построен кампус и достъпна облачна функция има отделни етапи, които трябва да се проверяват поотделно.

Център за данни и облачен регион

Документацията на Compute Engine определя регионите и зоните като логически абстракции върху физическите ресурси. Разпределянето между зони и региони служи за различни граници на отказ. Някои ресурси са зонални, други регионални или глобални. Следователно работеща сграда не установява автоматично всички възможности, местоположения и условия на услугите за външен клиент.

За условен екип, който планира AI помощник за потребители в региона, първата задача би била да установи наличните интерфейси и ресурси при действителното пускане. Нашата препоръка е да се проверят нужните модели, мрежови зависимости, квоти и възстановяване. Прессъобщението не трябва да замества този технически преглед или да служи като обещание за собствен срок към клиент.

Портфолиото се проверява по продукт

Публичната страница Cloud locations уточнява, че регионалното продуктово портфолио се развива и някои услуги имат различна функционалност според местоположението. Тя описва начален набор и допълнителни услуги след старта. Това е обща продуктова рамка, а не конкретно удостоверение, че всички AI възможности са готови в бъдещия малайзийски регион.

В собствен пилот бихме проследили цялата заявка: къде се намира входът, къде се обработва и къде се съхранява резултатът. Прехвърляне към друга услуга може да добави различна зависимост, дори основният ресурс да е близо до потребителя. Това е инженерна препоръка за преглед на архитектурата, не наше измерване на новата инфраструктура или правно заключение за конкретни данни.

Същият преглед трябва да установи какво става, ако предпочитаният ресурс не е достъпен. Резервен път може да запази работата на приложението, но да промени разхода или мястото на обработка. Екипът трябва да разбира това поведение, преди да разчита на него. Това е предложена проверка при внедряване, а не обявена функция на малайзийския план на Google.

Ефективност и общо потребление

Страницата на Google за ефективността обяснява PUE като отношение между общата енергия на центъра и енергията за IT оборудването. Стойност по-близо до единица означава по-малък относителен разход за поддържащите системи. Тя не показва самостоятелно абсолютното потребление или извършената полезна работа на дадено AI приложение. Затова сравнение изисква ясна граница на измерването.

Същото разграничение е полезно при четене на план за нова енергийна мощност. Мощността описва капацитет, докато потреблението за период е друга величина. Добавен капацитет сам по себе си не установява какъв източник обслужва всяка заявка във всеки час. В тази публикация не изчисляваме въглероден отпечатък и не удостоверяваме изпълнено екологично обещание.

Кои следи биха показали напредък

За проследяване на плана бихме отделили строителните етапи, реалната достъпност на услугите и отчетите за ресурсите. Всеки от тези показатели отговаря на различен въпрос. Предварително заявена инвестиция не е счетоводен отчет за вече изразходвана сума, а прогнозно въздействие не е измерен резултат.

Установеното събитие е новият мащабен ангажимент на Google в Малайзия и описаните етапи на развитие. За читателя, който взема технологично решение, практическата полза е да следи кога този ангажимент се превръща в конкретна достъпна услуга. Няма основание бъдещите кампуси и предстоящият регион да се обявяват за напълно готови само въз основа на сумата в заглавието.

Източници / допълнително четене
Google Malaysia investment announcement ↗
Compute Engine: regions and zones ↗
Google Cloud locations and product availability ↗
Google Data Centers: PUE methodology ↗

Статия в SIExpo.bg: https://siexpo.bg/article/google-malaysia-ai-infrastructure-investment-2026
 
StateBench проверява дали AI следи промените, вместо само да намира стар факт

Новото представяне на Ai2 разглежда четири вида проследяване на състояния. Резултатите различават предварително обучени модели от модели, обучени специално за синтетичните задачи.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

allenai-statebench-long-context-tracking-2026-f3c127ed828f3c23.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Ai2 представи StateBench в публикация от 3 ноември, след подаването на техническия препринт на 2 ноември. Наборът разглежда как езикови модели проследяват променящи се стойности в дълъг контекст. В описаните опити с водещи модели точността пада силно при най-трудните дълги последователности. Това не е измерване на всички реални разговори и не означава, че всяка задача с голям документ е еднакво трудна.

Намиране на стойност и изчисляване на състояние

Препринтът разделя задачите на четири теоретично мотивирани нива: неизменна стойност, презаписване с нова стойност, промяна според собственото предишно състояние и зависимости между различни променливи. Така един тест за дълъг контекст може да различава търсенето на запис от натрупването на последователни промени. Авторите разглеждат и различия между transformer и рекурентни архитектури, при определени математически допускания.

Наша ежедневна аналогия е движение на пратка. Първият запис може да казва, че тя е в склад А. По-късно е преместена в Б, върната е и е прехвърлена към друга пратка. Въпросът за сегашното местоположение изисква повече от намиране на изречение, съдържащо името ѝ. Това е редакционен пример за разликата, не задача от публикувания набор.

Сравнимите задачи започват от една следа

Публичният код генерира възпроизводими последователности от присвоявания и ги представя в различни повърхностни формати. По-простите семейства се извеждат от обща изходна следа, като се запазват определени характеристики на задачата. Това помага различие във формулировката или броя операции да не се смесва безконтролно с вида на необходимото проследяване.

Картата на набора в Hugging Face показва полета за операции, заявки, крайно състояние и дължини на зависимости. Тя предоставя по-конкретен артефакт за изследване от общо твърдение, че моделът има добра памет. Видимата структура обаче не прави автоматично синтетичните примери представителни за служебни документи или разговори на български.

При повторение на експеримента бихме запазили версията на набора и избраното представяне заедно с резултата. Иначе следващо изпълнение може да изглежда по-добро, докато всъщност използва различна постановка. Важно е сравняваните отговори да се отнасят към едни и същи примери и критерии. Това е предложена практика за сравними изследвания, не доказателство, че ние сме изпълнили StateBench.

Предварително обучение и специализирано обучение

Представянето на Ai2 различава готови модели от по-малки модели, обучени директно върху задачата. Във втория режим рекурентни и хибридни варианти обобщават по-добре към някои по-дълги последователности. Настоящата постановка използва фиксиран брой променливи. Не обхваща автоматично разговор, в който непрекъснато се появяват нови хора, предмети или проекти.

Оттук нашият извод е ограничен: специализираното обучение показва какво може да се научи в конкретен експеримент. То не доказва, че вече използваният корпоративен помощник е придобил същата способност. Също така теоретично свойство на архитектура при зададени допускания не е готово измерване за всяка нейна практическа реализация.

Какво да проверява екипът със собствен помощник

За пилот бихме подготвили няколко истории на промени с предварително известно крайно състояние. Част от тях биха съдържали директни корекции, други — зависимости между два записа. Бихме запазили една и съща информация, но бихме променили разстоянието между свързаните събития. Така може да се наблюдава дали проблемът е в намирането на запис или в прилагането на промяната.

Важно е очакваният отговор да се определи независимо от изпитвания модел. Ако същият помощник създава историята, решава я и обявява успех, липсва полезна външна проверка. За бизнес процес бихме сравнили крайното твърдение и с действителната система, която пази статуса. Това е предложен метод, не извършен от SIExpo тест.

StateBench е полезен принос именно защото разделя трудността на по-конкретни случаи. За читателя практическата поука е, че размерът на контекстния прозорец не е самостоятелна гаранция за правилно текущо състояние. Нужни са подходяща задача, проверим отговор и ясно разграничение между запомнен текст и последователно приложени промени.

Източници / допълнително четене
Ai2: StateBench presentation ↗
A Fine-Grained Hierarchy and Benchmark for State Tracking in Language Models ↗
StateBench public generation and evaluation code ↗
StateBench public dataset card ↗

Статия в SIExpo.bg: https://siexpo.bg/article/allenai-statebench-long-context-tracking-2026
 
Сравнение на IBM показва колко силно средата за AI агент влияе на резултата

CUGA, Hermes и Deep Agents са изпитани с един модел върху AppWorld. Различните настройки и липсата на политики в теста ограничават извода за корпоративна употреба.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

ibm-cuga-harness-appworld-comparison-2026-a195792900c80a8f.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Екипът на CUGA от IBM Research публикува на 3 ноември сравнение на три среди за AI агенти с GLM-5.3-flash. В извадката от 90 AppWorld задачи CUGA завършва 73, Hermes — 42, а Deep Agents — 27. Конфигурациите обаче не са еднакви; CUGA използва специализирана настройка за AppWorld. Това е авторски експеримент на екипа, не независима класация на всички възможни употреби.

Авторите изрично посочват, че в тези изпълнения не са използвани политики. Следователно резултатът не измерва ефективността на механизмите за налагане на бизнес правила. Разделяме двете теми, вместо да представим високата завършеност като доказателство за безопасно внедряване.

Какво прави средата около модела

Нашият редакционен прочит започва от прост пример: помощник трябва да намери поръчка, да прочете статуса ѝ и да предложи следваща стъпка. Моделът избира какво да поиска, но средата определя наличните инструменти, резултата от извикването и продължаването на процеса. Смяна на тази организация може да промени резултата дори когато самият модел остава същият.

Публичното хранилище harbor-eval, към което сочат авторите, е fork на рамката Harbor за оценяване на агенти и среди. То позволява да се проследи използваната технологична основа. Наличието на код не означава, че SIExpo е възпроизвел конкретното сравнение. За собствено повторение бихме записали точни версии, настройки, бюджет и критерии за завършване, преди да сравняваме проценти.

Правило в инструкцията и правило преди действието

Документацията на CUGA отделя насоки като Playbook и Tool Guide от проверки преди изпълнение и одобрение от човек. Политиките се задействат по входа, контекста или използването на инструмент. Това е архитектурно описание на проекта, а не независимо удостоверяване, че всяка конфигурация налага правилата правилно.

Ръководството за ToolGuard уточнява, че генериран проверяващ код може да блокира извикването преди оригиналният инструмент да се изпълни. Без приложено правило за даден инструмент този механизъм не го блокира автоматично. За екипа това създава конкретна задача: да провери не само съдържанието на правилото, но и дали правилният инструмент действително минава през него.

В наш условен пример помощникът може да подготви промяна на клиентски запис, но записването изисква проверка на позволените полета. Убедително обяснение на промяната не е доказателство, че техническият път е ограничен. При пилот бихме изпитали допустим и недопустим случай и бихме наблюдавали дали вторият изобщо достига до приемащата услуга. Тук не съобщаваме за проведен такъв тест.

Същият подход е необходим, когато приложението предлага няколко пътя към сходна операция. Проверката на един видим бутон не установява какво става през друга интеграция. Предложеният от нас преглед би описал действителните пътища за запис и доказателствата, нужни за всеки от тях. Това е препоръка за интеграция, а не още един резултат от benchmark на CUGA.

Човешкото одобрение има собствен жизнен цикъл

Отделното ръководство Tool Approval описва спиране за потвърждение след генериране на кода и възобновяване чрез отговор към агента. Показването на кода е настройка, а автоматичното одобряване след време е отделен параметър с изключена стойност по подразбиране. Затова видим бутон за одобрение не е достатъчен без преглед на конкретната конфигурация.

При внедряване нашата препоръка е одобрението да остава свързано с точното предложено действие. Ако аргументите се променят, човекът трябва да разбира коя операция приема. Също толкова важно е възобновяването след прекъсване: то не трябва да превърне вече изпълнена операция в ново изпращане само защото разговорът е продължил.

Какъв извод позволява сравнението

Изследването дава добър повод изборът на среда за агент да се третира като отделно инженерно решение. За реален пилот бихме измервали завършени задачи, откази и нужда от намеса върху собствен работен поток. Оценката на тези резултати и оценката на ограниченията върху действията трябва да останат отделни. Публикуваните числа подкрепят въпрос за конфигурацията, а не обща гаранция, че един продукт е най-добрият за всяка организация.

Източници / допълнително четене
IBM Research: same model, different agent harness ↗
CUGA harbor-eval public repository ↗
CUGA policy management overview ↗
CUGA ToolGuard guide ↗
CUGA Tool Approval guide ↗

Статия в SIExpo.bg: https://siexpo.bg/article/ibm-cuga-harness-appworld-comparison-2026
 
Dharma-AI представи малък модел за извличане на полета от документи

Field Extractor преобразува документни изображения в структуриран JSON. Публикуваните резултати са фирмен benchmark; валиден формат и вярно извлечени стойности изискват отделни проверки.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

dharma-field-extractor-json-documents-2026-92da8419faa926fc.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Dharma-AI представи на 4 ноември Field Extractor: модел с два милиарда параметъра за извличане на полета от документни изображения. Авторите описват свободно извличане и работа по зададена схема, включително връщане на null за липсваща стойност. Техният тест върху 546 документа съчетава съвпадение на полета, сходство на стойности и валиден JSON, а не процент напълно безгрешни документи. Това са публикувани фирмени измервания, не независима оценка от SIExpo.

Сравнението на разходите съпоставя самостоятелно изпълнение върху L40S с API цени според токените. То не е крайна цена за клиент и не включва еднакъв оперативен модел от двете страни. Съществената новина е специализацията за определена документна задача, а не доказано превъзходство над всеки общ модел.

Какво се променя след разчитането на страницата

Практическата разлика може да се обясни с наша примерна фактура. Прочетеният текст съдържа име на доставчик, няколко дати и повече от една сума. За счетоводно приложение е важно коя дата е падеж и коя сума е общата, а не просто дали всички знаци присъстват в транскрипцията. Пренасянето към структурирани полета добавя задача по интерпретация.

В такъв процес грешките могат да бъдат тихи. Числото изглежда правдоподобно, полето има очакваното име и импортът завършва, но стойността е взета от друг ред. Затова нашата препоръка е да се пази връзка към страницата и конкретния документ, за да може спорно извличане да бъде проверено. Това е редакционен модел на внедряване, не обявена функция на продукта.

Схемата проверява структурата

Официалната документация на JSON Schema показва, че описването на properties само по себе си не прави всички полета задължителни и не забранява допълнителни. За тези ограничения се използват отделни правила, включително required и additionalProperties. Null и отсъстващо свойство също не са едно и също. Тези детайли имат значение, ако получателят разчита на точно определен договор за данните.

Структурна проверка не може сама да установи дали сумата съответства на оригиналната фактура. В собствен пилот бихме разделили проверката на формат от проверката на съдържание. Едната установява дали документът може да се обработи от следващата система; другата сравнява стойностите с действителния източник. Само успешно разчитане на JSON не е достатъчен критерий за приемане.

Практическа разлика има и между отхвърляне на непълен обект и тихо запълване на празно място. Приемащото приложение трябва изрично да обработва липсващ падеж, без да го приема за действителна дата. Бихме показали това състояние на проверяващия и бихме го изпитали, преди резултатът да задейства последваща работа. Това е редакционно изискване към целия работен поток, а не допълнително обещание на доставчика.

Предисторията не е същият модел

Априлският препринт DharmaOCR разглежда специализирано OCR и проблема с повтарящи се, прекомерно дълги генерирания. Авторите свързват този дефект и с по-високи разходи и закъснение. Той дава контекст за специализацията, но неговите модели и резултати не трябва да се смесват с новия Field Extractor. Не твърдим, че априлските тегла представляват обявения през ноември checkpoint.

Публичният FUNSD, използван в документни изследвания, съдържа анотирани шумни сканирани формуляри и отношения между семантични единици. Такъв набор помага за проверимост на определени задачи. Той не е автоматично представителен за формулярите на всяка организация, на всеки език и при всяко качество на сканиране.

Как би изглеждала полезна приемателна проверка

Бихме избрали документи от действителния поток, включително празни полета, многостранични таблици и повредени сканове. За всяко поле бихме записали очакваната стойност и кои грешки изискват човешки преглед. Примерно грешен падеж може да е по-съществен от различно изписване на описателен текст, дори общата средна оценка да изглежда добра.

Същата проверка трябва да отчете повторната обработка. Ако документът пристигне втори път, валиден отговор не бива автоматично да създава втора операция в приемащата система. Това е въпрос към интеграцията около модела. Новото предложение заслужава оценка като по-тясно специализиран инструмент, с ясно разграничение между заявените резултати и доказаното върху собствените документи.

Източници / допълнително четене
Dharma Field Extractor announcement ↗
DharmaOCR research preprint ↗
FUNSD: Form Understanding in Noisy Scanned Documents ↗
JSON Schema object reference ↗

Статия в SIExpo.bg: https://siexpo.bg/article/dharma-field-extractor-json-documents-2026
 
Авторски разбор: Phonon пренася синтеза на реч върху устройството

Техническата публикация от 5 ноември разглежда вече пуснатите модели на Gradium. Езикът, лицензът и първото изтегляне са съществени за реална офлайн интеграция.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

phonon-local-speech-technical-review-november-2026-319b24508b845548.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Gradium и автори от Hugging Face публикуваха на 5 ноември технически преглед на Phonon, семейство малки модели за синтез на реч. Текстът изрично описва първите две седмици след отварянето на моделите. Следователно това не е нов старт на продукта днес. Поводът за нашия авторски разбор е по-подробният поглед към локалната обработка и интеграцията ѝ в приложения.

Изберете конкретен модел, а не само име на семейство

Публичната карта на Phonon 31m описва английски модел с Apache 2.0 лиценз, 24 kHz моно звук и квантизирани тегла с размер 64,5 MB. Посочените 31 милиона параметъра не включват аудио токенизатора. Това е полезно разграничение при оценка на общия пакет, който трябва да се достави на потребителя.

Картата на Phonon 40m Multilingual посочва английски, френски, немски, испански и португалски, но лицензът е CC BY-NC 4.0. Достъпът до файловете изисква приемане на условията в Hugging Face. Български не е сред изброените езици. Отворено видима карта на модел и разрешение за всяка търговска употреба са различни неща; екипът трябва да избере подходящия вариант преди включване в продукт.

Офлайн работа има и етап на подготовка

Хранилището xn-ptts съдържа Rust среда за изпълнение, която не изисква PyTorch, и интеграции за различни платформи. По подразбиране част от инструментите изтеглят и кешират модела при първо използване. Локална папка с предварително подготвени файлове е отделен вариант. Следователно обещанието за работа без мрежа трябва да се проверява след доставянето на необходимите ресурси, а не само при вече затоплен демонстрационен екземпляр.

В практичен редакционен пример приложение за инструкции в склад може да трябва да прочете съобщение при липса на връзка. Пилотната проверка би започнала на чисто устройство: наличен ли е моделът, избран ли е правилният глас и какво вижда човекът, ако подготовката е прекъсната? Това не е проведен от SIExpo тест. То е критерий за приемане на конкретна интеграция, която не бива да показва готовност само защото бутонът за звук е наличен.

Потокът от звук и завършеното изречение

Документацията на Transformers описва последователно генериране на аудио представяния, които процесорът декодира до звук. Това обяснява защо начало на възпроизвеждането и готовност на целия запис са различни моменти. За интерфейса нашата препоръка е да се наблюдават и двата: човек може да чуе началото бързо, но да чака останалата част или да поиска прекъсване.

При оценяване бихме проверили също числа, продуктови означения и изречения с необичайна пунктуация от действителното приложение. Приятен демонстрационен глас не установява правилно произнасяне на конкретни имена. Нито компактният файл сам по себе си показва използваната работна памет, разхода на батерия или поведението при едновременно натоварване. Тези въпроси изискват измерване върху избраното устройство.

За потребителски пилот бихме записали малък повтаряем набор от реални инструкции и бихме помолили слушателите да разпознаят важните подробности, без да виждат текста. Въпросът е дали съобщението е предадено правилно, включително означение, което променя действието. Бихме пазили и грешните произнасяния за повторна проверка след обновяване. Това е предложен редакционен метод за оценка, а не отчетен резултат на Phonon.

Какво могат да кажат класациите

Методиката на Open TTS Leaderboard разглежда отделно разбираемост, скорост и естественост; има и слушане и сравняване на записи. Един показател не обобщава всички качества на гласа. Не пренасяме фирмено твърдение за първенство в универсална препоръка и не съобщаваме собствен сравнителен резултат.

За внедряване бихме записали версията на модела, езика, гласа, устройството и условията на изпитване. Добрата приемателна проверка включва и отказ: липсващ ресурс, невалиден вход или прекъсната заявка трябва да доведат до разбираемо състояние. Стойността на локалния синтез е възможността приложенията да говорят без постоянна облачна заявка. Дали това е подходящо за конкретен продукт зависи от качеството, правата за употреба и завършения потребителски процес.

Източници / допълнително четене
Phonon: technical overview and launch retrospective ↗
Phonon 31m English model card ↗
Phonon 40m Multilingual model card ↗
xn-ptts runtime and deployment paths ↗
Transformers: Gradium Phonon TTS ↗
Open TTS Leaderboard methodology ↗

Статия в SIExpo.bg: https://siexpo.bg/article/phonon-local-speech-technical-review-november-2026
 
Agility обяви начало на търговията на Nasdaq с фокус върху мащабирането на Digit

Компанията съобщи за приключено бизнес обединение и около 465 млн. долара брутен капитал. Поръчките за Digit 5 и бъдещите внедрявания остават обвързани с условия и срокове.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

agility-nasdaq-aglt-listing-robotics-commercialization-2026-b79881ab6fd740d8.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Agility съобщи на 5 ноември за начало на търговията на Nasdaq под символите AGLT за акциите и AGLTW за варантите след бизнес обединението с Churchill Capital Corp XI. Според компанията сделката и свързаното финансиране осигуряват приблизително 465 млн. долара брутен капитал преди разходите. Това е корпоративен етап за разработчика на Digit, а не доказателство, че хуманоидните роботи вече са масово внедрени.

Какво е приключило и какво предстои

Предишното съобщение от 4 ноември потвърждава приключването на обединението и описва смяната на борсовите символи. То посочва инфраструктурата RoboFab и платформата Agility Arc като части от плановете за производство и управление на роботи. Проектният капацитет на фабрика не бива да се чете като отчетено годишно производство. Между построена инфраструктура, доставена машина и работеща клиентска услуга има отделни етапи.

Нашият редакционен прочит е, че достъпът до капитал има значение само заедно с изпълнението. Производството трябва да бъде съчетано с инсталиране, обучение на оператори, резервни части и поддръжка. Дори една машина да изпълнява добре определено движение, клиентът купува работещ процес през цялата смяна. Затова оценката на напредъка изисква информация за ежедневна работа, а не само за броя поръчани устройства.

Поръчките са различни от приходите

В новото съобщение Agility посочва над 300 млн. долара поети многогодишни поръчки за Digit 5, обвързани с договорни етапи, характеристики и спецификации. Това е заявен от доставчика ангажимент за бъдещо изпълнение. Не го представяме като вече получени приходи или като независима оценка на търсенето. Не сме проверявали счетоводните записи или реално изпълнените обеми.

Контекст от клиентската страна дава съобщението на GXO от 26 октомври. То описва планирано разширяване в Statesville и Lebanon в началото на 2027 г., първо с Digit 4 и преминаване към Digit 5 при търговската му наличност. Това е съвместно партньорско съобщение, не независим одит. То обаче уточнява последователността и показва защо бъдещият модел не трябва да се смесва с вече използваното поколение.

Продуктовите показатели имат условия

Страницата на Digit 5 рекламира товар до 23 кг, обхват 2,2 метра и интеграция с други складови системи. Това са продуктови спецификации на производителя. Те не установяват производителност във всеки склад и не заменят оценката на конкретната работна зона. Възможността да се пренесе контейнер и икономически полезното изпълнение на цял цикъл са различни измервания.

За примерен клиентски тест бихме избрали една операция: вземане, пренасяне и поставяне на определен контейнер. След това бихме измерили колко цикъла са завършени, какви намеси са били нужни и какво става при неподходящо поставен предмет. Това са наши предложени критерии, не публикувани резултати за Digit. Така може да се сравнява промяна в работния процес, вместо да се разчита на единична демонстрация.

Борсовото съобщение е новината; мащабирането на роботната услуга остава задача за следващите периоди. Не представяме данни за движение на цената или прогноза за възвръщаемост. Полезната следваща информация за технологичния сектор ще бъде как заявените поръчки се превръщат в доставени системи и как тези системи работят при повторяеми клиентски условия.

Източници / допълнително четене
Agility Nasdaq trading announcement ↗
Agility business combination completion ↗
GXO and Agility partnership expansion ↗
Agility Digit 5 product specifications ↗

Статия в SIExpo.bg: https://siexpo.bg/article/agility-nasdaq-aglt-listing-robotics-commercialization-2026
 
Meta започна пускането на глас и изразителни аватари в Muse в САЩ

Новите функции се разгръщат за мобилното приложение, уеб и Mac. Технологичният фон е представен по-рано; пускането не означава потвърдена достъпност за България.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

meta-muse-voice-expressive-avatars-us-rollout-2026-fc813ad1f55760d0.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Meta съобщи на 5 ноември, че започва поетапно включване на гласови разговори и изразителни аватари в Muse, първоначално в САЩ. Обявени са мобилното приложение, уеб и Mac. Разговорът може да бъде само с глас или с видим аватар; поддържа се прекъсване на отговора. Разговорите през AI Glasses и Muse Charm са описани като предстоящи, а не като вече включени навсякъде.

Нов интерфейс към агент

Това е промяна в начина на взаимодействие с Muse, не първо представяне на цялата система. В септемврийската публикация Meta описва агента като работещ в отделна облачна виртуална машина и заявява, че потребителят избира свързаните услуги и обхвата на достъпа. Посочва се потвърждение преди чувствителни действия. Тези твърдения са описание на доставчика; не сме правили независим одит на тяхното изпълнение.

Редакционният ни прочит е, че разговорният интерфейс променя скоростта, с която човек дава и поправя задача. При писмено задание ограниченията могат да се прегледат заедно. В разговор те се натрупват през няколко реплики. Следователно полезната проверка е дали окончателното намерение е видимо и разбираемо, преди агентът да направи нещо с външен резултат. Плавният диалог и правилното изпълнение трябва да се оценяват отделно.

Как аватарът следва гласа

Техническата публикация на Meta от 23 септември описва общ поток от речеви токени за звука и визуалното поведение. Аватарът генерира видео на кратки последователни части и използва скорошен генериран контекст за продължаване на движението. Това обяснява как се цели синхрон между говор и образ. То не е доказателство, че системата разбира задачата по-добре заради изражението си.

Практичен пример би бил репетиция на презентация. Човек може да сменя формулировките, да задава уточнения и да поиска по-кратък отговор. Полезността тук може да се оцени по яснотата на обратната връзка и възможността разговорът да бъде коригиран. Убедително кимане или дружелюбен тон не трябва да се приема за проверка на фактите в презентацията. Примерът е наш анализ на приложението, не доклад за собствен тест на Muse.

Какво не е установено за местния читател

Официалното съобщение за пускането не потвърждава обща наличност в България или конкретно качество на български език. Не сме проверявали местен акаунт и не обещаваме, че функцията ще се появи при всеки потребител. Регионалното включване, работещият микрофон и подходящото устройство са отделни условия от самото съществуване на технологията.

При реално изпробване бихме разграничили три проверки: разбира ли се вярно казаното, запазват ли се важните ограничения след прекъсване и показва ли се ясен резултат от задачата? За действие като изпращане на текст бихме сравнили крайния текст с последното изрично указание. Това са предложени критерии за оценяване; не твърдим, че открихме дефект или че тези случаи вече са проверени.

Новината е конкретното поетапно пускане на новия интерфейс. Неговата стойност ще зависи от съчетаването на удобен разговор с видимо управление на задачите и достъпа. Наличните източници позволяват да опишем дизайна и обявения обхват; не позволяват да заключим, че изразителният аватар премахва грешките на агента или че е готов за всяка езикова и регионална среда.

Източници / допълнително четене
Meta: Give Your Muse a Voice ↗
Meta AI: Bringing Your Muse to Life ↗
Meta: Introducing Muse ↗

Статия в SIExpo.bg: https://siexpo.bg/article/meta-muse-voice-expressive-avatars-us-rollout-2026
 
Cloudflare предложи общ подход за доверие между сайтове, хора и AI агенти

Инициативата Trusted Agent Delegation търси съвместими правила за агенти посредници. Разпознаването на оператора, правата за действие и отговорността остават различни въпроси.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

cloudflare-trusted-agent-delegation-coalition-2026-7041c72cecacd68a.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Cloudflare обяви на 5 ноември инициативата Trusted Agent Delegation за сътрудничество около достъпа на персонални AI агенти до сайтове. Компанията поставя проблема при облачно управляваните посредници: сайтът вижда инфраструктурата на агента, но не непременно човека зад всяка задача. Това е предложение за обща работа по протоколи и изисквания, а не съобщение, че вече има завършен универсален стандарт за делегиране.

Кой действа и какво му е позволено

Страницата на инициативата описва целта като запазване на връзката между сайта и потребителя с ограничено споделяне на лични данни. Примерният сценарий е човек, който сменя агента си, но продължава да използва същия търговец. Това е желано бъдещо поведение, не доказателство, че всеки магазин вече може да го поддържа. Съвместимостта трябва да бъде изградена между участниците.

Нашият прочит е, че тук има поне три отделни решения. Първо сайтът трябва да знае дали заявката действително идва от заявения оператор. След това трябва да реши дали конкретният акаунт има достъп. Накрая трябва да провери дали поисканото действие е в даденото разрешение. Положителен отговор на първия въпрос не решава останалите два.

Подписът има конкретна роля

Документацията на Web Bot Auth описва подписване на HTTP заявки за разпознаване на ботове и агенти. Тя посочва и ограничения на поддържаните компоненти. Пренасянето на доверие чрез Forwarded е отбелязано като експериментално. Следователно не е коректно от наличието на подпис автоматично да се заключи, че човек е одобрил конкретна покупка или че посредническата верига е напълно установена.

Например агент може да сравнява цени за един клиент, а после да получи задача да направи поръчка. От гледна точка на приложението това са различни операции. Нашата препоръка е разрешението за четене да не се използва като подразбиращо се разрешение за промяна. При поръчката трябва да е ясно какво точно се потвърждава и към коя сесия принадлежи записът. Примерът е редакционно обяснение, не нова спецификация на TAD.

Какво вече предлага доставчикът

Отделната продуктова публикация на Cloudflare от 4 ноември описва видимост за персонални асистенти и правила за достъп. Account Abuse Protection е в ранен достъп; според компанията може да свързва събития с акаунт и да позволява реакция срещу него, вместо блокиране на целия агент. Това е описание на конкретния продукт, а не независима проверка на ефективността или наличност за всеки план.

За собственик на портал полезният първи въпрос е кои действия натоварват или променят системата. Търсенето, създаването на обява и изпращането на съобщение могат да имат различни ограничения. Бихме започнали с отделни правила, ясни съобщения за отказ и наблюдение на грешките. Така позволеният агент няма да трябва да отгатва правилата чрез поредица от неуспешни опити.

Какво още трябва да се докаже

Инициативата има смисъл като обща рамка за разговор, но важните практически въпроси остават: отмяна на разрешение, прехвърляне между оператори, минимален обем данни и проследяване на спорно действие. Не сме провеждали тест на внедряване. Ще оценяваме бъдещите реализации по това дали тези случаи са описани и проверими, а не само по наличието на етикет „доверен агент“.

Източници / допълнително четене
Cloudflare: Agents aren’t humans (but they kinda are) ↗
Trusted Agent Delegation initiative ↗
Web Bot Auth documentation ↗
Cloudflare personal-agent visibility and control ↗

Статия в SIExpo.bg: https://siexpo.bg/article/cloudflare-trusted-agent-delegation-coalition-2026
 
LeRobot 0.7 свързва обучение от поточни данни с интерактивно управление на роботи

Версията добавя езиково взаимодействие по време на работа и изпълнение на политики на отделен GPU сървър. Документацията показва и ограниченията на тези възможности.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

lerobot-070-streaming-interactive-remote-inference-2026-f5033087f6792a02.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

Екипът на LeRobot представи версия 0.7.0 на 5 ноември с промени в два свързани етапа: подготовката на роботни политики и използването им на реална машина. Съобщението акцентира върху интерактивни инструкции, поточно четене на големи набори и обучение на по-големи модели. За разработчика същественото е как тези части се съчетават в повторим работен процес, а не само колко имена на модели присъстват в списъка.

Инструкцията може да се променя по време на работа

Документацията за изпълнение описва интерактивни сесии с команди за подзадача, въпрос към визуалното възприятие и избор на следващи подзадачи. Въпросите и автоматичното планиране изискват политика, която генерира текст, или външен планировчик. Следователно една нова команда в терминала не превръща всяка съществуваща политика в разговорен робот. Способностите зависят от конкретния модел и неговата интеграция.

Наш пример за оценяване би бил подреждане на няколко предмета на маса. Първо се задава ограничена задача; след това човек променя само една инструкция. Важният въпрос е дали действието отразява новата цел и дали записът позволява да се види кога тя е приета. Полученият словесен отговор сам по себе си не доказва, че движението е правилно. Това е предложен тест, не изпитване, което сме провели.

Големият набор не трябва да се копира целият

Страницата за обучение с поток описва четене на нужните Parquet данни и диапазони от MP4 файлове без предварително сваляне на целия набор. Разпределянето работи с цели епизоди и определено покритие на кадрите. Има локални индекси и разходи при началната подготовка; режимът не означава липса на памет, мрежов трафик или изчакване. Документацията различава този входен поток от поточното кодиране при запис.

Практическият ни прочит е, че дисковият проблем се превръща в задача за измерване на целия поток. Ако GPU чака данни, повече изчислителна мощност няма непременно да помогне. Бихме сравнили времето до първата партида, използваната памет и паузите при четене върху един и същ малък набор. След това може да се реши дали тесният участък е декодирането, връзката или самото обучение.

Моделът може да бъде на друга машина

Отделното ръководство за remote inference разделя GPU сървъра от компютъра, свързан към робота. Локално остават камерите, моторите и буферът с предстоящи действия. Докато се изчислява следващата поредица, роботът може да следва вече получената. Ръководството различава политики, проверени на хардуер, от такива с поддръжка само на ниво интерфейсен договор.

Това разделяне създава полезен избор, но и конкретен компромис: продължаването на старата траектория запазва плавността, докато новото наблюдение може да изисква промяна. В собствена лаборатория бихме проверили какво става при забавена връзка, изчерпан буфер и променена сцена. Нужни са предварително определени критерии за спиране и наблюдение от оператор; това са наши препоръки към оценяването, не твърдение за налична универсална защита.

Как да се чете версията

LeRobot 0.7 е набор от инструменти за изграждане и проверка на система. Не сме възпроизвеждали публикуваните ускорения или роботни демонстрации. Най-полезното начало е една известна политика, един ограничен сценарий и запазен запис на данните, инструкциите и действията. Така всяка следваща промяна може да се оцени по поведението на целия процес, вместо по изолирано обещание за по-бърз компонент.

Източници / допълнително четене
LeRobot 0.7.0 release overview ↗
LeRobot policy deployment ↗
LeRobot training dataset streaming ↗
LeRobot remote inference ↗

Статия в SIExpo.bg: https://siexpo.bg/article/lerobot-070-streaming-interactive-remote-inference-2026
 
Авторски разбор: как четири модела Cosmos 3 свързват действията със симулирани наблюдения

Техническата публикация на NVIDIA от 5 ноември разглежда вече налични модели за автомобили и роботи. Проверихме разликата между генерирано видео, интерактивна симулация и доказателство за надеждност.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

cosmos3-interactive-simulation-checkpoints-technical-review-2026-4dbe19a55d907a32.jpg


Редакционна илюстрация, създадена с AI.

Подготвено с помощта на AI по посочените източници. Първоначалните публикации принадлежат на цитираните автори; материалът е редакционен обзор, а не независима проверка на всяко твърдение.

NVIDIA публикува на 5 ноември технически обзор на четири специализирани варианта на Cosmos 3 Nano. Поводът за този авторски разбор е новото обяснение на работните им режими, а не ново издаване на всички тегла: моделната карта на Sim-Auto посочва 20 октомври 2026 г. Тази разлика е важна за читател, който следи кое вече може да изпробва и кое тепърва е обявено.

Четири различни задачи

Обзорът разграничава Transfer-Auto за синтетични автомобилни данни, Sim-Auto за последователни автомобилни наблюдения, Sim-Transfer за визуализация от контроли на симулатор и Sim-Bimanual за видео, обусловено от роботни действия. Това са специализирани инструменти, а не един универсален заместител на физическа среда. При избор на вариант началният въпрос трябва да бъде какви входове има екипът и какъв изход иска да измери.

Картата на Sim-Auto описва съвместно генериране на камери и LiDAR, управлявано чрез World Scenario Map. Поддържат се до 11 камери. Посочената кадрова честота на възпроизвеждане не е скорост на изчислението; публикуваните измервания на производителността зависят от конфигурацията. Следователно думата „интерактивен“ сама по себе си не казва дали конкретна машина ще изпълнява конкретен сценарий достатъчно бързо.

Защо красивият клип не е достатъчен

Нашият редакционен прочит е, че полезността идва от връзката между действие и последица. Представете си тестова политика, която завива, след като види препятствие. Ако генерираният изглед изглежда убедително, но препятствието сменя позицията си без основание, оценката на политиката става подвеждаща. Системата може да произведе качествена картина и едновременно да бъде слаб инструмент за този конкретен експеримент.

Затова бихме разделили оценяването на отделни въпроси: съответстват ли различните сензори, запазват ли се обектите през времето и реагира ли сцената последователно на подадените контроли? Това е предложен от нас начин за проверка, не резултат от собствено изпитване на Cosmos. Число за визуално качество не бива автоматично да отговаря вместо всички тези проверки.

Данните са част от модела

Отделният договор за данни в хранилището на NVIDIA изисква подготвен локален пакет, а не произволна папка със записи. Описани са съгласувани наблюдения и действия, калибрация, единици и разделяне на епизодите между обучение и оценяване. Документът изрично различава статична проверка от действително декодиране на пример. Това е полезен контекст за цената на адаптирането към собствен робот.

Например при собствена роботна ръка бихме проследили един кратък запис от камерата до крайните входни тензори. Ако команда за затваряне на захвата е кодирана с обратен знак, по-дългото обучение няма да поправи смисъла на данните. Същото важи за разминаване във времето: кадър преди движението и действие след него могат да образуват неправилна учебна двойка. Примерът и препоръката са наш инженерен анализ.

Какво е установено

Проверихме публичния обзор, моделната карта и документацията за данни. Не сме изпълнявали модела и не потвърждаваме самостоятелно неговите показатели. Практическият извод е да се избере един ограничен сценарий, да се запазят входовете и настройките и да се сравнят генерираните наблюдения с отделен контролен запис. Едва след това има смисъл да се преценява дали разширяването на симулацията носи стойност за конкретната задача.

Източници / допълнително четене
NVIDIA: Interactive World Simulation technical overview ↗
NVIDIA Sim-Auto model card ↗
NVIDIA Bimanual data contract ↗

Статия в SIExpo.bg: https://siexpo.bg/article/cosmos3-interactive-simulation-checkpoints-technical-review-2026
 

Горе