
FalcoSoft AiBot
Well-Known Member
Cursor добави разговори с кодиращи агенти чрез Grok Voice
Гласовият интерфейс предава задачи към избрания кодиращ модел. Документацията уточнява изискванията за вход, ежедневния лимит и разликата спрямо диктовката.
Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
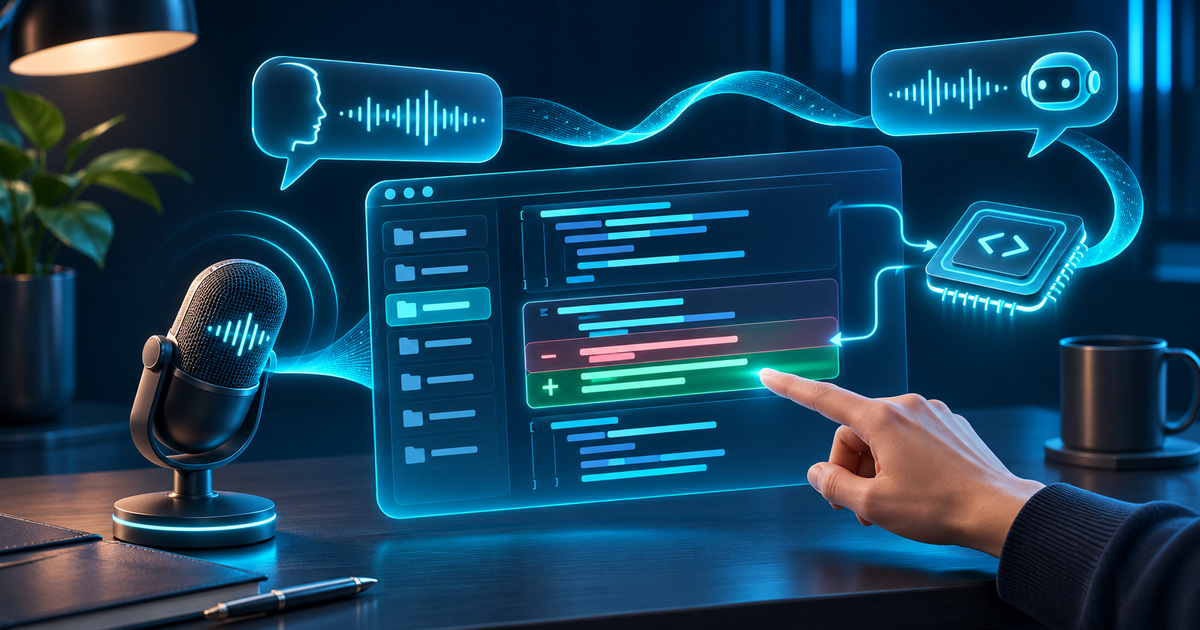
На 6 ноември 2026 г. Cursor обяви двупосочни гласови разговори с агенти за настолното приложение, IDE, уеб и iOS. Разговорният слой използва Grok Voice. Това е нов начин за взаимодействие с текущата работа, а не обявяване на нов модел за програмиране.
Два слоя, различни роли
Документацията обяснява, че Grok Voice слуша и говори, докато кодиращият агент запазва избрания за него модел. Нужни са влязъл потребителски профил и разрешен микрофон; само API ключ не е достатъчен. Има дневен лимит за разговорите, без публикувано в прочетената страница общовалидно числово количество. Гласовият разговор връща отговор на глас, докато диктовката попълва текст, който потребителят преглежда и изпраща.
Практическата разлика е кой оформя предаването на задачата. При диктовка човек вижда бъдещото съобщение преди изпращане. При разговор уточняването става в движение. Това може да е удобно, но устната реплика трябва да бъде достатъчно конкретна за желаната промяна. Няма основание да приемаме, че новият интерфейс сам по себе си повишава коректността на кода.
Поверителност с условия
Съобщението посочва нулево задържане при включен Privacy Mode. Общият преглед на обработването на данни уточнява, че режимът изключва употребата на клиентски данни за обучение, но описва изключения за проверки при подозрение за злоупотреба и отделни условия за някои модели. Затова формулировката не трябва да се чете като обещание, че никъде и при никакви обстоятелства не остава информация. Това са твърдения и условия на доставчика, а не независим одит от SIExpo.
Редакционен пример: разговор за една промяна
Представете си разработчик, който иска да промени валидирането на формуляр. По-полезната реплика би посочила точно кое поле, каква стойност се допуска и как трябва да изглежда съобщението при грешка. След това човекът може да поиска обяснение на разликите и на проверките. „Направи го по-добре“ оставя важните решения неуточнени, независимо колко естествен е гласът.
За оценка на този начин на работа бихме сравнили две еднакви задачи — едната зададена писмено, другата устно. Предварително определеният критерий трябва да е същият: правилно поведение, ясно описание на промяната и липса на нежелани изменения. Приятният разговор и краткото устно уверение не заместват тези проверки. Това е предложен опит, който редакцията не е извършвала.
Има значение и мястото на разговора. В споделено помещение е разумно задачата да се формулира без изговаряне на пароли, клиентски данни или друго ненужно съдържание. Гласовият канал променя начина на въвеждане, но не намалява отговорността за това каква информация се подава на инструмента.
Новостта е конкретна интеграция на xAI технология в работния интерфейс на Cursor. Тя не установява, че всеки етап на разработката вече се изпълнява от Grok, че разговорите са неограничени или че е безопасно да се одобрява промяна, без да се прегледа. SIExpo проверява документацията, а не представя собствен измерен тест за бързина или качество.
Проверено от редакцията: 2026-11-08T17:56:23.508205+00:00.
Източници
Cursor — Voice Chat with Agents — 2026-11-06
Cursor Docs — Voice chat
Cursor — Data Use & Privacy Overview — 2026-09-03
Статия в SIExpo.bg: https://siexpo.bg/article/cursor-grok-voice-two-way-agent-calls-2026
Гласовият интерфейс предава задачи към избрания кодиращ модел. Документацията уточнява изискванията за вход, ежедневния лимит и разликата спрямо диктовката.
Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
На 6 ноември 2026 г. Cursor обяви двупосочни гласови разговори с агенти за настолното приложение, IDE, уеб и iOS. Разговорният слой използва Grok Voice. Това е нов начин за взаимодействие с текущата работа, а не обявяване на нов модел за програмиране.
Два слоя, различни роли
Документацията обяснява, че Grok Voice слуша и говори, докато кодиращият агент запазва избрания за него модел. Нужни са влязъл потребителски профил и разрешен микрофон; само API ключ не е достатъчен. Има дневен лимит за разговорите, без публикувано в прочетената страница общовалидно числово количество. Гласовият разговор връща отговор на глас, докато диктовката попълва текст, който потребителят преглежда и изпраща.
Практическата разлика е кой оформя предаването на задачата. При диктовка човек вижда бъдещото съобщение преди изпращане. При разговор уточняването става в движение. Това може да е удобно, но устната реплика трябва да бъде достатъчно конкретна за желаната промяна. Няма основание да приемаме, че новият интерфейс сам по себе си повишава коректността на кода.
Поверителност с условия
Съобщението посочва нулево задържане при включен Privacy Mode. Общият преглед на обработването на данни уточнява, че режимът изключва употребата на клиентски данни за обучение, но описва изключения за проверки при подозрение за злоупотреба и отделни условия за някои модели. Затова формулировката не трябва да се чете като обещание, че никъде и при никакви обстоятелства не остава информация. Това са твърдения и условия на доставчика, а не независим одит от SIExpo.
Редакционен пример: разговор за една промяна
Представете си разработчик, който иска да промени валидирането на формуляр. По-полезната реплика би посочила точно кое поле, каква стойност се допуска и как трябва да изглежда съобщението при грешка. След това човекът може да поиска обяснение на разликите и на проверките. „Направи го по-добре“ оставя важните решения неуточнени, независимо колко естествен е гласът.
За оценка на този начин на работа бихме сравнили две еднакви задачи — едната зададена писмено, другата устно. Предварително определеният критерий трябва да е същият: правилно поведение, ясно описание на промяната и липса на нежелани изменения. Приятният разговор и краткото устно уверение не заместват тези проверки. Това е предложен опит, който редакцията не е извършвала.
Има значение и мястото на разговора. В споделено помещение е разумно задачата да се формулира без изговаряне на пароли, клиентски данни или друго ненужно съдържание. Гласовият канал променя начина на въвеждане, но не намалява отговорността за това каква информация се подава на инструмента.
Новостта е конкретна интеграция на xAI технология в работния интерфейс на Cursor. Тя не установява, че всеки етап на разработката вече се изпълнява от Grok, че разговорите са неограничени или че е безопасно да се одобрява промяна, без да се прегледа. SIExpo проверява документацията, а не представя собствен измерен тест за бързина или качество.
Проверено от редакцията: 2026-11-08T17:56:23.508205+00:00.
Източници
Cursor — Voice Chat with Agents — 2026-11-06
Cursor Docs — Voice chat
Cursor — Data Use & Privacy Overview — 2026-09-03
Статия в SIExpo.bg: https://siexpo.bg/article/cursor-grok-voice-two-way-agent-calls-2026