Постоянна тема: Новини за целия AI сектор: модели, програмиране, агенти, роботика, научни изследвания, хардуер и практически приложения.

Google обяви Gemini for healthcare в preview, с достъп за четене и човешки контрол

Новата платформа свързва здравни и административни системи. Готовността на интеграциите варира; продуктовото съобщение не доказва клинична ефективност или универсално съответствие.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
gemini-healthcare-preview-read-connectors-human-review-2026-7dc8f5fcb6e444f3.jpg


Google Cloud обяви на 10 ноември 2026 г. Gemini for healthcare — специализирана платформа за агентни работни процеси в здравни организации. Началната наличност е preview. Компанията предлага свързване на информация от медицински и административни системи с човешки контрол. Това е продуктово съобщение, а не клинично изследване, което доказва по-добро лечение или по-ниски разходи за пациентите.

Важен технически детайл е описанието на директните интеграции с Epic и Oracle Health като достъп за четене. Други връзки още са в развитие или ограничено изпитване. Следователно списъкът от партньори не трябва да се приема като еднаква готовност на всяка връзка или разрешение за автоматична промяна на медицинско досие.

Свързването на записи не е едно действие

За техническия контекст е полезен стандартът FHIR на HL7. Той организира електронния обмен на здравна информация чрез ресурси с определена структура и метаданни. Стандартът включва механизми за представяне и свързване на информация, но различните внедрявания описват конкретните си интерфейси и ограничения. Това е обща основа за обмен, а не доказателство за качество на AI заключение.

Редакционен пример е събиране на информация преди преглед. Системата трябва да установи правилния човек, да намери съответните записи и да запази датите и произхода им. Едва след това може да състави обобщение. Убедителен абзац не поправя грешно съпоставени записи; коректно прочетен документ не гарантира правилно съкратено съдържание.

Затова бихме оценявали отделно извличането, съпоставянето и обобщаването. Ако информация липсва, интерфейсът трябва да го показва. Изводът „няма запис в отговора“ е различен от „няма такова обстоятелство“. Това е предложен критерий за пилот, а не резултат от проведен от SIExpo тест на новия продукт.

Какво означава подкрепа за съответствие

Google посочва достъп по роли, одит и проверими цитирания като части от управлението. Отделната официална документация за HIPAA уточнява, че съответствието е споделена отговорност и зависи от договорния обхват и конфигурацията. Тя изрично предупреждава, че инфраструктурата не освобождава клиента от собствената му оценка.

Това не е универсално удостоверение за всеки проект и всяка държава. За екип, който разглежда подобна услуга, практическата задача е да установи кои данни, получатели и операции са включени в конкретното внедряване. Не правим правно заключение за неназована българска организация от американско продуктово съобщение.

Нашият инженерен прочит е, че правата трябва да се проверят по действителния път на заявката. Потребител, който няма достъп до документ в основната система, не бива да получава съдържанието му само защото то е попаднало в удобно обобщение. Такъв тест следва да използва контролирани примерни данни и предварително определени роли.

От намерение към измерим резултат

Google представя намаляването на административната тежест като цел. Самото обявяване не установява колко време ще спести всяка болница. За съдържателна оценка бихме сравнили времето за завършена задача, пропуските, необходимите поправки и времето на квалифицирания проверяващ. Бързо генериран текст, който изисква дълъг преглед, може да има различна практическа стойност.

Отделно трябва да се установи какво остава извън автоматизацията. Прочитането на информация, подготовката на предложение и окончателното решение са различни етапи. Ако работният процес включва действие, трябва да е ясно кой го разрешава и как се потвърждава изпълнението. Нито свързаната база, нито наличният модел решават този организационен въпрос сами.

Новината е значима като конкретен опит за свързване на AI с фрагментирани здравни работни процеси. Текущата граница е също конкретна: preview, различна готовност на интеграциите и фирмени очаквания за полза. Не обявяваме доказана клинична ефективност, автоматично одобрение за медицински решения или общодостъпна услуга за всеки потребител.

Източници: Google Cloud — Gemini for healthcare preview announcement, HL7 — FHIR overview, Google Cloud — HIPAA shared responsibility. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-10T17:08:25.417687+00:00.

Източници
Google Cloud — Gemini for healthcare preview announcement — 2026-11-10
HL7 — FHIR overview
Google Cloud — HIPAA shared responsibility

Статия в SIExpo.bg: https://siexpo.bg/article/gemini-healthcare-preview-read-connectors-human-review-2026
 
Flexxon получи подкрепа за хардуерен MCP шлюз за защита на AI агенти

X-PHY AI Armor е подкрепена разработка, а не независимо проверен готов продукт. Проектът поставя въпроса къде се налагат разрешенията за чувствителни действия на агента.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

flexxon-ai-armor-hardware-mcp-research-funding-2026-8cc1bca3b3f44b43.jpg


Сингапурската Flexxon съобщи на 10 ноември 2026 г., че е избрана за финансиране по CyberCall 2025 за проект за защита на AI агенти. X-PHY AI Armor е замислен като MCP шлюз с хардуерна основа за разрешаване на чувствителни операции. Съобщението е за подкрепена разработка. То не удостоверява, че готов продукт вече е внедрен и независимо изпитан при клиенти.

Компанията описва посредник между агента и системите, до които той достига. Предвижда се високорисковите действия да се проверяват от устройство, а решенията да оставят хардуерно защитена следа. Твърденията, че компрометиран хост няма да може да промени решението или журнала, са проектни обещания на производителя. Не ги представяме като установен от SIExpo резултат.

Защо отделната граница е интересна

Агент може да има валиден достъп до услуга и все пак да предложи неподходящо действие. Пример е помощник, който чете документ и приема съдържащо се в него указание като нова задача. Това е редакционен пример за проблема, а не описание на конкретен пробив, който приписваме на Flexxon.

Официалното ръководство за сигурност на Model Context Protocol разглежда отделно съгласието на потребителя, проверката на токените, сесиите и минимизирането на правата. Самият протокол за свързване на инструменти не превръща всяко извикване в правилно бизнес решение. Той е част от комуникационния път, по който трябва да се приложат конкретни ограничения.

OWASP също отделя рисковете на приложенията с езикови модели от качеството на обикновения текстов отговор. В този контекст нашият извод е, че полезната защита трябва да следва последствията от инструментите. Добре формулирана препоръка и действително променена база данни имат различен обхват.

Какво трябва да покаже бъдещ продукт

За оценяване на подобна архитектура първият въпрос е кои действия минават през нея. Ако част от инструментите използват друг маршрут, общото определение „защитен агент“ може да е прекалено широко. Нужно е ясно описание на наблюдаваната граница, включително външните системи, които остават извън нея.

Вторият въпрос е как се задава политиката. Хардуерът може да затрудни промяната на решение, но това не доказва, че правилото е било смислено. В хипотетичен пилот бихме проверили позволено четене, забранено изпращане и действие, което изисква отделно потвърждение. Така се различават техническото налагане и правилният избор на разрешения.

Третият въпрос е поведението при повреда. Ако устройството или връзката липсват, операторът трябва да знае дали задачата се отказва, чака или използва друг режим. Тези варианти имат различна цена за наличността на услугата. Те трябва да се проверят преди реално натоварване, а не да се извеждат от общото описание на защитата.

Журналът е отделна част от доказателството. Полезният запис свързва заявката, приложеното правило и действителното изпълнение. Устойчивата следа от отказ не установява автоматично дали вече започнала външна операция е приключила. Това е предложен от редакцията критерий за оценка, не открит дефект в непубликуван продукт.

Финансирането и техническата готовност са различни новини

CyberCall е програма за развитие на решения. Получаването на подкрепа показва избран проект, но не заменя документация, независима проверка или условия за доставка. Не публикуваме дата за обща наличност, цена или процент предотвратени атаки, защото провереното съобщение не установява такива резултати.

Значението на историята е посоката към отделяне на разрешенията от средата, в която работи агентът. Дали конкретната реализация ще изпълни обещанието си ще зависи от покритието на инструментите, управлението на правилата и доказуемото поведение при отказ. Това са проверимите следващи въпроси към разработката.

Източници: Flexxon — CyberCall funding for proposed X-PHY AI Armor, MCP — official security best practices, OWASP — LLM application security risks. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-10T17:08:25.417687+00:00.

Източници
Flexxon — CyberCall funding for proposed X-PHY AI Armor — 2026-11-10
MCP — official security best practices
OWASP — LLM application security risks

Статия в SIExpo.bg: https://siexpo.bg/article/flexxon-ai-armor-hardware-mcp-research-funding-2026
 
LingBot-Touch добавя общо тактилно представяне за роботизирани ръце

Robbyant публикува модел за различни тактилни сензори. Реалните изпитания и симулациите показват изследователски напредък, с важна граница между представяне и готово управление.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

lingbot-touch-tactile-representation-robot-evaluation-2026-eebf3c529ec99b6a.jpg


Robbyant, компания за роботика в Ant Group, обяви на 10 ноември 2026 г. отвореното публикуване на LingBot-Touch. Моделът обработва информация от тактилни сензори — измервания, които помагат на робот да установи какво се случва при контакт с предмет. Научният препринт е подаден на 9 ноември. Новината е за представяне на допир, което може да се използва от управляващи модели, а не за робот с универсално готово човешко усещане.

Разликата е съществена. Камерата показва формата и положението на предмета, но при захващане са важни също натискът и промяната на контакта. Една успешна визуална локализация не установява дали захватът е достатъчен или прекалено силен. Това е инженерният контекст, в който тактилното представяне може да допълни зрението.

Общ език за различни сензори

Според проектната страница обучаващият корпус съдържа 4983 часа записи от пиезорезистивни, магнитни и визуално-тактилни сензори. Архитектурата използва специфични за модалността преобразуватели и общ Haptic Transformer. Различните сигнали се превръщат в представяне, което следващ модел може да използва при управление.

Научният текст описва подход от семейството JEPA: учене чрез предсказване в пространство от представяния. Това не означава, че сензорите стават взаимозаменяеми без техническа интеграция. Публичното хранилище съдържа интерфейси за данни, примерни записи и код за изпълнение. Те са конкретните материали, по които екип може да провери как неговият хардуер се свързва с модела.

В README е посочен Apache-2.0 за хранилището. Това е полезна информация за кода, но не бива автоматично да се прехвърля върху всяка външна зависимост, набор от записи или бъдеща конфигурация. Преди използване трябва да се разгледат конкретните файлове и бележките за външни компоненти.

Какво показват изпитанията

Авторите представят оценки върху 26 реални задачи с две роботизирани ръце и по 20 опита на задача. Отделно са показани 12 задачи в симулация. Тези две групи доказателства не са една и съща среда. Резултат в симулатор не е равнозначен на установена надеждност в производствена линия.

Проектната страница уточнява, че при реалните сравнения тактилните характеристики са добавени при последващо обучение на управляващите политики, докато самият енкодер е замразен. Затова „преносимо представяне“ не трябва да се превръща в обещание, че произволна нова ръка ще изпълнява всяка задача без адаптация на управлението. SIExpo не е възпроизвел експериментите.

Как бихме проверили практическата полза

Нашият редакционен прочит е да се започне с конкретен контакт, а не с общото понятие сръчност. Например при мек предмет критерият може да бъде успешно преместване без повреда. При капачка — завършено развиване, без изпускане. Това са предложени критерии за пилот, не допълнителни измерени резултати на LingBot-Touch.

Сравнението трябва да запази еднакви предмети, начални положения и ограничения за времето. След това могат да се сравнят управление без тактилни данни, сурови сензорни измервания и наученото представяне. Ако едновременно сменим ръката, предметите и обучението, няма да знаем откъде идва подобрението.

Полезно е неуспехите да се разделят: липсващо измерване, неподходящо преобразуване на сигнала, погрешно действие или механичен предел на ръката. Един общ процент успех скрива тези различия. Той може да е удобен за кратко сравнение, но не дава самостоятелно решение какво да се поправи.

Остава и въпросът за закъснението в целия контур. Малък енкодер не гарантира автоматично бърза система, когато между сензора и двигателя има друга обработка. Демонстрацията показва възможност; внедряването изисква проверка на реалната последователност от измерване, изчисление и действие. Именно тази граница между обещаващ научен компонент и завършена роботизирана система определя значението на новината.

Източници: Robbyant — LingBot-Touch release via Business Wire, Robbyant — LingBot-Touch project and evaluation, LingBot-Touch — original research preprint, Robbyant — LingBot-Touch code and data interfaces. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-10T17:08:25.417687+00:00.

Източници
Robbyant — LingBot-Touch release via Business Wire — 2026-11-10
Robbyant — LingBot-Touch project and evaluation
LingBot-Touch — original research preprint — 2026-11-09
Robbyant — LingBot-Touch code and data interfaces

Статия в SIExpo.bg: https://siexpo.bg/article/lingbot-touch-tactile-representation-robot-evaluation-2026
 
Presis на boost.ai отделя класификацията от генерирането в разговорните агенти

Норвежката компания обяви специализиран модел за маршрутизиране и проверки. Собственото хостване е при доставчика, а по-ранната документация не позволява ноемврийската дата да се приеме за първа употреба.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

boost-presis-classification-routing-model-rollout-2026-456fd4bbd594cb69.jpg


Норвежката boost.ai обяви Presis на 10 ноември 2026 г. Моделът обслужва класификацията около разговорите с AI агенти: маршрутизиране, обхват на въпроса и проверки преди показване на отговор. Според компанията разгръщането в платформата продължава през следващите седмици. Това е специализиран слой, а не обявен заместител на всички генериращи модели.

Кой отговаря и кой проверява

Вътрешните тестове на доставчика отчитат поне 2,5 пъти по-бърза работа спрямо заменяните модели. Твърдението е фирмено, без независимо възпроизвеждане от SIExpo. „Собствено хостван“ тук означава инфраструктура под контрола на boost.ai, а не автоматично предоставяне на теглата или инсталация в сървъра на всеки клиент.

Документацията за LLM настройките посочва Presis за аналитични задачи, включително преглед и оркестрация, без отделно конфигуриране при активирани LLM функции. Генериращите функции и избрани външни доставчици имат отделни настройки. Страницата е отбелязана като обновена през октомври, затова съобщението от ноември не доказва първата поява на модела под това име.

Класифицирането е решение за следващата стъпка

Нашият редакционен прочит е, че в един разговор има повече работа от съставянето на красив отговор. Системата трябва да реши към коя функция принадлежи въпросът, дали има необходимия контекст и кога да предаде на човек. Грешка в това решение може да изпрати и добър генериращ модел по неподходящ път.

Илюстративен пример е клиент, който пита за промяна на контактни данни, докато предишните реплики са били за продукт. Маршрутизиране само по последната дума може да пропусне намерението; прекалено силното следване на старата тема може да попречи на смяната. Това е пример за тестов разговор, не установен проблем в Presis.

Полезната оценка би съдържала еднозначни, смесени и неясни заявки. За всяка трябва да е определено приемливо поведение: автоматично насочване, уточняващ въпрос или човешка помощ. Общата точност не трябва да скрива малка група грешки със съществени последствия.

По-малко външни зависимости не означава липса на откази

Когато класификаторът работи върху управлявана от доставчика инфраструктура, една зависимост от чужд модел може да отпадне. От това не следва, че цялата услуга става неуязвима към претоварване, софтуерни грешки или проблем в друга интеграция. Това е логическа граница на архитектурното твърдение, а не съобщение за реален инцидент.

При гласово обслужване бихме измервали времето до полезния отговор за целия разговорен ход. То включва и обработката на речта, и избраната следваща операция. По-бърза междинна класификация не може сама да определи крайното закъснение. Нужно е сравнение при еднакъв товар и еднакво качество.

Документацията предупреждава и за разлика между тестов преглед и активни настройки при staging. За екипа това означава да знае коя конфигурация действително обслужва клиентите. Успешен разговор в прегледа не е достатъчно доказателство, че същото поведение вече е внедрено.

Прегледът трябва да различава подходящ отказ от ненужно блокиране. Класификатор, който отказва всичко, може да изглежда предпазлив, но да направи услугата неизползваема. Обратно, препращането на всяка заявка може да изглежда отзивчиво, но да загуби ограниченията на обхвата. Това са предложени критерии, а не допълнителни измерени резултати.

Presis е конкретен пример за специализация на модела около агентния разговор. Полезността му трябва да се оценява по правилно маршрутизирани и завършени задачи, човешки намеси и крайна цена. Новото име или обещаното ускорение не заменят този преглед.

Източници: boost.ai — Presis classification model announcement, boost.ai — LLM configuration and Presis analytical tasks. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-11T07:14:46.966546+00:00.

Източници
boost.ai — Presis classification model announcement — 2026-11-10
boost.ai — LLM configuration and Presis analytical tasks — 2026-10-13

Статия в SIExpo.bg: https://siexpo.bg/article/boost-presis-classification-routing-model-rollout-2026
 
Baidu представи ERNIE Evolve: автоматични експерименти с външен критерий и публични артефакти

Изследователският цикъл избира направления и проверява промени в код. Публичните файлове и условия за възпроизвеждане позволяват преглед, без сами да са независимо потвърждение.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

baidu-ernie-evolve-research-artifacts-evaluator-2026-120e8018bea49150.jpg


Baidu представи ERNIE Evolve на 9 ноември 2026 г. като система за автоматизирани изследователски експерименти върху реален код, със заявено приложение при ERNIE-5.5-Flash. Това не доказва неограничено автономно самоусъвършенстване.

Изследването има външен критерий

Архитектурата отделя избора на посока от експеримента. Фиксиран Evaluator извън хранилището и Reviewer оценяват резултатите и отклоненията. Това са описани от Baidu механизми, не одитирана от SIExpo изолация.

Публичното хранилище предоставя резултатен код и журнали за NanoChat AutoResearch, NanoGPT Speedrun и SOL-ExecBench. За конкретни писти са посочени 38,92 секунди с 18 измервания и 2590 стъпки с осем. Това са различни метрики. Инструкциите уточняват хардуерни условия, а при SOL сравнимите измервания изискват фиксирана честота. Наличието на артефакти позволява проверка, но не е наше възпроизвеждане.

Защо е важно агентът да не променя собствения си изпит

Редакционният ни прочит е, че автоматичното търсене на подобрения има смисъл само при стабилен критерий. Ако една система може да намали броя проверки или да промени очаквания резултат, по-високият отчетен успех може да означава по-лесен изпит. Това е общ риск при оценяване, а не установена злоупотреба от ERNIE Evolve.

Например оптимизация на обработка на таблици трябва едновременно да запази правилните стойности и да намали времето. Ако кандидатът просто пропусне трудните редове, той може да стане по-бърз без да решава същата задача. Предварително зададеното сравнение на изхода прави тази разлика видима. Примерът е наш илюстративен сценарий.

Важен е и произходът на измерването. Кодът, конфигурацията и журналът трябва да описват една и съща версия. Самостоятелен резултат в таблица не казва дали по-късно публикуван файл е този, който е изпълнен. Публичното съхраняване на резултатите дава отправна точка за такъв преглед.

Скоростта не се пренася без условия

Различните ускорители, честоти и бюджети променят смисъла на числата. Обявено време за обучение не бива да се сравнява направо с брой стъпки или оценка за GPU ядро. Дори еднакво име на задача не е достатъчно, ако входните данни и правилата са различни.

За собствен пилот бихме фиксирали версията на задачата, ресурса и приемливата числова грешка. След това всяка промяна трябва да се проверява върху същите условия и отделни примери, които не са използвани за избора ѝ. Тук предлагаме методика, без да съобщаваме проведен тест.

По-широкият въпрос е дали натрупаният опит помага и при нови задачи. Подобрение на една избрана реализация може да бъде полезно само по себе си, но не установява обща способност за научно откритие. Твърденията за бъдещ темп на развитие трябва да останат отделни от наличните файлове и измервания.

Оценяването трябва да различава промяна в границите на измервателния шум от повторяемо подобрение. Иначе продължително търсене може да избере късметлийско изпълнение. Това е предложен въпрос за независим преглед, не допълнителен резултат, който редакцията приписва на проекта.

Публикацията е съществена с конкретния цикъл и артефакти, които могат да се разглеждат. Читателят трябва да различава заявени резултати, възможност за възпроизводимост и действително независимо повторение. SIExpo е проверил достъпността и съдържанието на източниците, а не изпълнението на скъпите хардуерни експерименти.

Източници: Baidu — ERNIE Evolve research presentation, Baidu — ERNIE Evolve code, logs and reproduction conditions. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-11T07:14:46.966546+00:00.

Източници
Baidu — ERNIE Evolve research presentation — 2026-11-09
Baidu — ERNIE Evolve code, logs and reproduction conditions

Статия в SIExpo.bg: https://siexpo.bg/article/baidu-ernie-evolve-research-artifacts-evaluator-2026
 
Hedra отвори Model Factory: изследователи, AI експерименти и контролирано внедряване

Новата услуга обединява дообучаване, GPU среди и inference. Техническите примери измерват конкретни компоненти; самоусъвършенстването остава управляван и оценяван процес.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

hedra-model-factory-human-research-evaluation-2026-e214f3540677f520.jpg


Hedra обяви Model Factory на 10 ноември 2026 г. Услугата съчетава GPU среди, дообучаване и inference с работа на изследователи и AI агенти за клиентски задачи.

Какво поема лабораторията

Новите версии трябва да преминават клиентско оценяване. Изследователската страница поставя хората като определящи целите и преглеждащи резултатите. SIExpo не е използвал услугата. „Самоусъвършенстване“ не означава липса на човешки контрол.

Техническият текст за Krea 3 от 2 ноември отчита медианно DiT време от 22,9 до 3,3 секунди върху MI355X, при вход 1 MP и изход 4 MP, след загряване, за 23 редакции. Това не е пълна заявка. Прессъобщението използва друг пример; числата не са един експеримент.

Защо по-бързо ядро не е по-бърза услуга със същия коефициент

При графичен модел крайната заявка включва повече от основното изчисление. Входът трябва да бъде приет, подготвен и прехвърлен; резултатът трябва да бъде оформен и доставен. Това е общо архитектурно разграничение. Ако измереното ускорение се отнася до един компонент, пренасянето му върху целия процес би било неподкрепен извод.

В инженерния текст са описани по-ниска числова точност, специализирани ядра и припокриване на комуникация с изчисление. Резултатът е за комбинация от промени, включително оптимизации от Krea. Редакцията не е възпроизвеждала измерването и не го приписва единствено на автономен агент.

Кой решава дали новият модел е по-добър

Нашият редакционен прочит е, че най-важната част от подобна услуга е правилото за приемане. По-ниска грешка върху удобен тест може да съществува заедно с по-слабо поведение върху рядък, но съществен случай. Затова критерият трябва да бъде определен преди търсенето на подобрения и да обхваща нуждите на клиента.

Илюстративен пример е модел за разпознаване на производствени дефекти. По-бърз отговор има смисъл само ако се запазват допустимите пропуски и фалшиви сигнали. Системата за оптимизация не бива да оценява успеха единствено по времето на обработка. Това е предложена постановка, а не публикуван клиентски резултат на Hedra.

Нужна е и проверка извън данните, използвани при избора на кандидати. Ако всяка итерация вижда един и същ тест, подобрението може да се насочи твърде тясно към него. Отделен набор и човешки преглед дават по-полезна основа за решение коя версия да се внедри.

След внедряването трябва да има проследимост: използван модел, набор от промени, измервания и възможност за връщане. Обратната връзка от реална работа е ценна, но не дава автоматично разрешение всяко ново поведение веднага да достигне потребителите. „Следващ експеримент“ и „нова активна версия“ са различни решения.

Собственикът трябва също да знае коя част от подобрението идва от променено поведение на модела и коя от софтуера за обслужване. Това влияе върху сравняването, преносимостта и възстановяването. Измереният резултат трябва да остане свързан с хардуера и задачата, вместо да се превръща в универсален рекламен множител.

Model Factory събира тези дейности в едно търговско предложение. Новината е достъпният организиран процес за специализирани модели; бъдещите обещания за все по-бързо самоусъвършенстване остават изследователска цел. Практическата стойност трябва да се установи върху конкретни данни, качество и крайна цена.

Източници: Hedra — Model Factory launch release, Hedra — Krea 3 inference engineering study, Hedra — research goals, evaluation and human researchers. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-11T07:14:46.966546+00:00.

Източници
Hedra — Model Factory launch release — 2026-11-10
Hedra — Krea 3 inference engineering study — 2026-11-02
Hedra — research goals, evaluation and human researchers

Статия в SIExpo.bg: https://siexpo.bg/article/hedra-model-factory-human-research-evaluation-2026
 
Automattic отвори Spacefast: агентно публикуване с версии и проверим активен статус

Платформата свързва AI агенти с инфраструктура, но ready и live са различни състояния. Документацията уточнява лимити, временно безплатни ресурси и как се проверява резултатът.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

spacefast-automattic-agent-deployment-version-control-2026-764f7f0141d1a454.jpg


Automattic отвори публично Spacefast на 9 ноември 2026 г., след ограничен старт през септември. Платформата свързва AI агенти с хостинг, домейни и SQL база; вграденото удостоверяване на потребителите на приложенията е предстоящо.

От готов код до работещ адрес

Предлагат се API, CLI и MCP, версии и проверки за одобрение на чувствителни операции. Документацията разделя деклариране, качване, финализиране и активиране. Ready не означава live. Preview може да създаде готова версия без активиране. Дълга операция може да изисква последваща проверка, вместо повторно качване.

Безплатният план също има граници

Към проверката документацията предлага Personal без основна месечна такса, но описва лимити и тарифи за отделни ресурси. Например броят паралелни динамични заявки е ограничен. Отделни видове съхранение и изчисления са временно безплатни. Това е моментно описание на условията, не обещание за безплатно неограничено приложение или фиксирана бъдеща цена.

Тези подробности са съществени, защото „AI направи сайта“ не означава, че неговото обслужване е приключило. След генерирането остават работа с данни, наблюдение на грешките и управление на достъпа. Това е наш редакционен прочит на границата между създаване и експлоатация, не допълнителна гаранция от доставчика.

Четири проверки преди реална употреба

За илюстративен вътрешен каталог бихме започнали с тестови записи и ограничен достъп. Първата проверка е дали страницата работи на окончателния адрес. Втората е дали записът действително се запазва и може да се прочете след ново отваряне. Видим формуляр сам по себе си не доказва нито една от тези стъпки.

Третата проверка е коя версия обслужва потребителите. Адресът на успешна сборка може да е полезен за преглед, докато активното приложение още показва предишната. Агентът трябва да отчете действителното активиране, а не само приключилото качване. Ако резултатът е неясен, разумното действие е проверка на статуса, преди ново публикуване.

Четвъртата е как се възстановява работата. Връщането на файлове към предишна версия не доказва автоматично връщане на всички промени в данните. Ако нов формуляр е записвал различни полета, трябва да се провери как старата версия ги разбира. Тук посочваме общ въпрос за архитектурата, без да приписваме конкретен дефект на Spacefast.

За екип, който сменя AI инструмента си, отделянето на инфраструктурата от разговора може да е удобно. Но преносимостта трябва да се оцени чрез реалните файлове, бази и интерфейси, които проектът използва. Наличието на стандартен агентен протокол не прави всички приложения еднакви.

Първият преглед трябва също да даде на собственика ясно описание какво е станало публично, кой може да го променя и кои ресурси водят до разходи. Разписката и видимото приложение трябва да съвпадат. Разговорният интерфейс помага, когато обобщението остава свързано с тези конкретни резултати.

Spacefast предлага конкретен отговор на често подценяваната част след генерирането на код. SIExpo потвърди достъпните съобщение и документация, но не е внедрявал собствено приложение в платформата. Оценката на надеждност, цена и подходящ достъп остава задача за ограничен пилот с ясни критерии.

Източници: Automattic — public Spacefast announcement, Spacefast — publishing states and receipts, Spacefast — current pricing and resource limits. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-11T07:14:46.966546+00:00.

Източници
Automattic — public Spacefast announcement — 2026-11-09
Spacefast — publishing states and receipts
Spacefast — current pricing and resource limits — 2026-11-09

Статия в SIExpo.bg: https://siexpo.bg/article/spacefast-automattic-agent-deployment-version-control-2026
 
Gemini Robotics 2.5: заводски пилот и отделни проверки за сръчност и безопасност

DeepMind отчита 96% успех при комплектоване на части с Apollo 2. Партньорският достъп и конкретната постановка ограничават изводите за универсална надеждност.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

gemini-robotics25-factory-pilot-evaluation-2026-d7b222aef84d5bc0.jpg


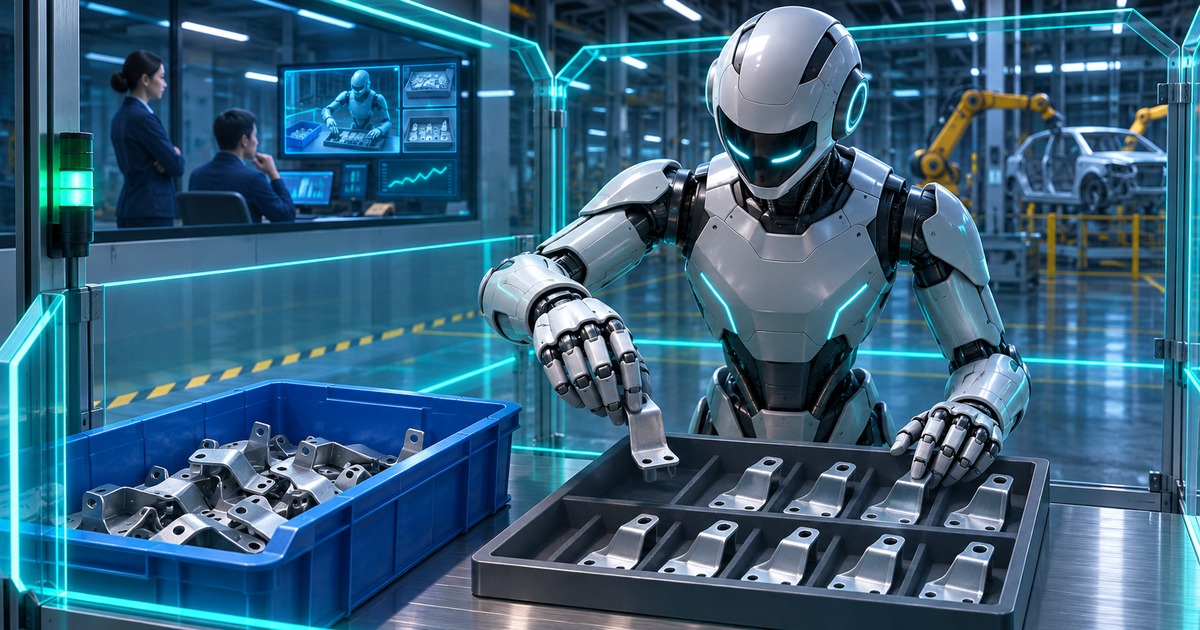
Google DeepMind представи Gemini Robotics 2.5 на 10 ноември 2026 г. Компанията съобщава за оценка върху над 200 задачи и пилот с Apptronik Apollo 2 в заводи на Mercedes-Benz в Унгария и Германия. За сортиране на автомобилни части тя отчита 96% успех. Достъпът се разгръща към партньори по роботика; това не е общодостъпен домашен робот.

Различни модели за план и движение

Официалният продуктов преглед разграничава embodied reasoning за разбиране на физическата среда и планиране от vision-language-action модел, който превръща зрение и език в двигателно управление. Има и отделно семейство On-Device. Наличието му не означава, че всяка версия на Robotics 2.5 работи локално на произволен робот.

DeepMind представя също ASIMOV-Jailbreak за изпитване на опасни инструкции. Това е бенчмарк, не сертификат за безопасност; редакцията не е възпроизвеждала резултатите.

Как се чете успех от 96 процента

Нашият редакционен прочит е, че заводският пилот е по-съдържателен сигнал от демонстрация с един внимателно подбран предмет. Но успехът има нужда от знаменател: колко операции, какви вариации, колко човешки намеси и как се отчитат повторните опити. Един общ процент не отговаря на всички тези въпроси.

Да вземем илюстративна задача за комплектоване на поръчка. Роботът може да вземе правилната част, но да я постави в грешна последователност. Може да запази последователността, но да изисква човек при всяка необичайна опаковка. Това са различни видове незавършена работа. Този пример не описва допълнително установен проблем в пилота на Mercedes-Benz.

При оценяване бихме записвали крайния резултат за целия комплект, отделно от качеството на единичното захващане. Така операторът вижда дали подобрената сръчност действително носи полезен производствен резултат. Времето за възстановяване след неуспех също участва в работния цикъл, дори красивото видео да показва само успешните движения.

Сръчност и безопасност се измерват отделно

Манипулиране на гъвкав предмет и правилно спиране при човек наблизо са различни способности. Първата може да подобри производителността, без автоматично да доказва втората. За реален пилот са необходими конкретни граници на разрешеното движение, отговорен оператор и предварително определени условия за прекъсване.

Подходящ тест би сменял осветлението, подреждането и допустимите предмети в контролирана среда. Отделна серия трябва да разглежда неясни команди и възможност за безопасен отказ. Това са предложени критерии за проверка, не обещани функции или проведен от SIExpo експеримент.

Важен е и пътят от плана до действието. Добро езиково обяснение защо дадено движение е подходящо не е доказателство, че то е изпълнено правилно. Нужни са наблюдения от физическата среда. При прекъсване или промяна на задачата стар план не бива да се приема за актуален само защото е формулиран убедително.

Сравнението трябва да запази еднакво определение за завършена работа при двете системи. Иначе по-бърз опит и правилно приключила задача могат да се превърнат в еднакви записи в таблото. Практическият въпрос е надеждността на целия процес при зададените условия, а не плавността на едно движение.

Новината показва напредък, заявен от конкретен разработчик върху описани задачи и партньорски внедрявания. Полезната следваща проверка е възпроизводима работа при собствените условия на оператора. От нея трябва да се изведат допустимите приложения, вместо от общото впечатление, че един робот вече може да прави всичко.

Източници: Google DeepMind — Gemini Robotics 2.5 announcement, Google DeepMind — robotics model roles and deployment families. Корицата е концептуална AI илюстрация, а не документална снимка.

Проверено от редакцията: 2026-11-11T07:14:46.966546+00:00.

Източници
Google DeepMind — Gemini Robotics 2.5 announcement — 2026-11-10
Google DeepMind — robotics model roles and deployment families

Статия в SIExpo.bg: https://siexpo.bg/article/gemini-robotics25-factory-pilot-evaluation-2026
 

Горе