Постоянна тема: Новини за целия AI сектор: модели, програмиране, агенти, роботика, научни изследвания, хардуер и практически приложения.

Нашвил разширява AI наблюдението на трафика: още 100 кръстовища по договор с Ouster

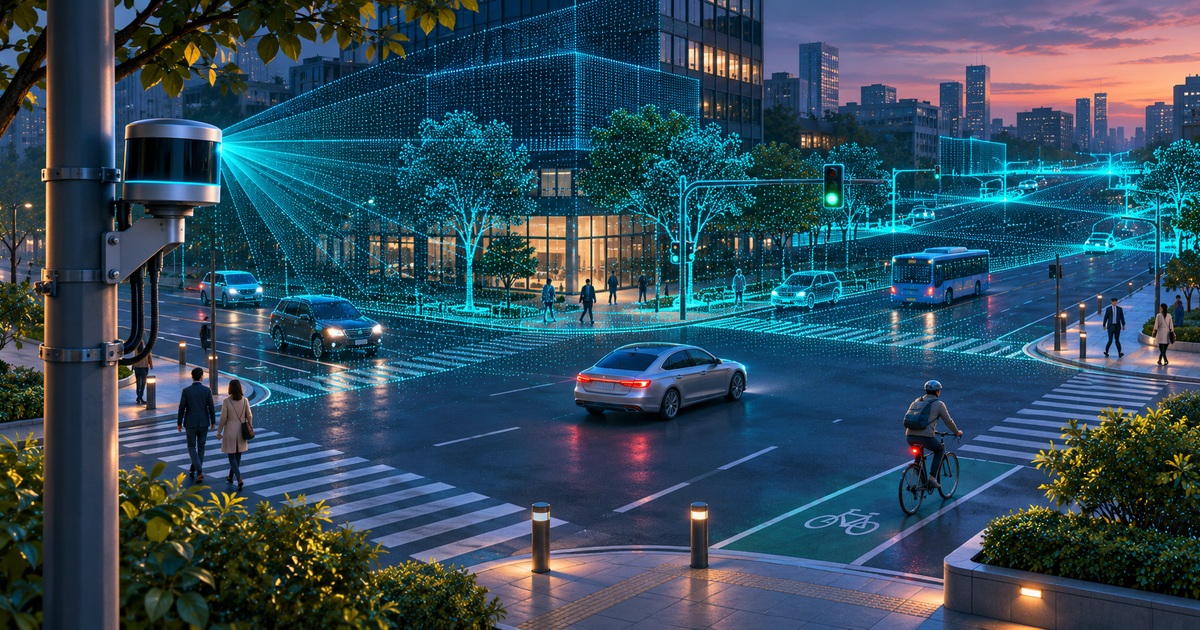
Ouster обяви на 17 ноември ново разширение на BlueCity в Нашвил за още 100 кръстовища. Компанията посочва над 200 договорени кръстовища и пътни локации общо. Договореният обхват трябва да се различава от брой вече завършени инсталации.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
ouster-nashville-100-intersections-rev8-contract-evidence-2026-a1b32e7d21b7257e.jpg


Ouster обяви на 17 ноември ново разширение на BlueCity в Нашвил за още 100 кръстовища. Компанията посочва над 200 договорени кръстовища и пътни локации общо. Договореният обхват трябва да се различава от брой вече завършени инсталации.

Системата съчетава 3D lidar и AI за проследяване на участници в движението. Разширението включва Rev8 OS1 Max с посочена детекция до 500 фута, приблизително 152 метра, и свързване със съществуващото управление на светофарите. Това са характеристики според доставчика, а не независими измервания на SIExpo.

От отделен датчик към обща улица

Нашият редакционен прочит е, че полезността на подобна система зависи от връзката между измерване и решение. Наблюдението на едно кръстовище може да покаже текущо присъствие. Управлението на цял коридор обаче изисква да се разбере как промяната на едно място влияе върху следващото.

Илюстративен въпрос за изпитание е дали намаленото чакане на автомобили се постига без прекомерно удължаване на чакането за пешеходци. Една обща средна стойност може да скрие подобен компромис. Това е предложен критерий, не установено въздействие на новия договор.

Проверимата оценка би запазила сравними часови пояси, типове движение и условия преди и след промяната. Тя би отчела и периодите, когато системата не може да работи нормално. Липсата на данни не бива да изглежда като отсъствие на участници в движението.

Откриване и обществен резултат са отделни оценки

Доброто разпознаване на обект е само една част от веригата. Следват преобразуването му в управляващ сигнал, правилата на светофарната система и реалното поведение на хората. За технически екип е полезно да има видимост на всяка граница, за да знае къде възниква грешка.

Също толкова важен е въпросът какви данни се запазват и кой ги вижда. Градската аналитика може да се оценява чрез необходимите показатели за движение, без автоматично да се приема, че всяка възможна подробност трябва да се съхранява. Конкретната политика изисква отделна проверка; тук не твърдим, че сме одитирали градската конфигурация.

Днешната новина показва разширяване на практическа инфраструктурна програма, а не доказан процент намаление на произшествията. Именно такава последваща оценка, с ясно определен обхват, би позволила да се разбере какво постига физическият AI за всички, които използват улицата. Договорът определя следващия мащаб; измерването трябва да покаже резултата.

Източници
Ouster — Nashville BlueCity expansion — 2026-11-17

Статия в SIExpo.bg: https://siexpo.bg/article/ouster-nashville-100-intersections-rev8-contract-evidence-2026
 
Dragonfly AI200 стига до избрани клиенти през Cirrascale: реалните натоварвания ще покажат икономиката

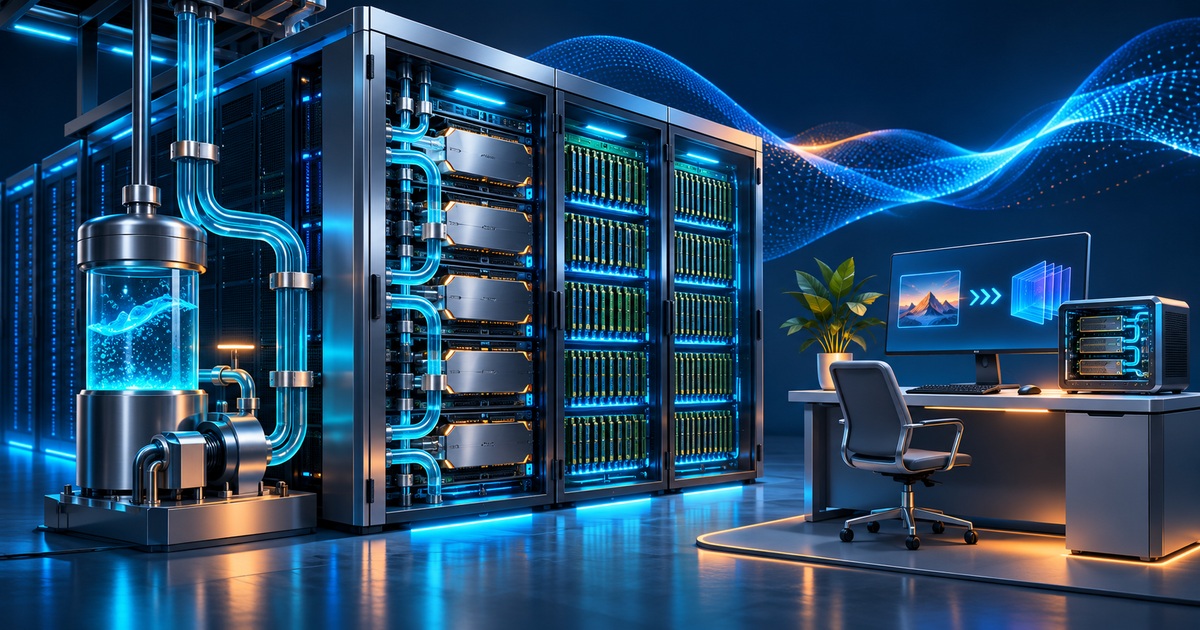
Qualcomm и Cirrascale обявиха на 17 ноември достъп за оценка на Dragonfly AI200 за избрани клиенти. Платформата е предназначена за AI inference на ниво шкаф. Това е контролиран път за изпитание със собствени натоварвания, а не съобщение за неограничен публичен достъп.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

qualcomm-dragonfly-ai200-cirrascale-selected-customer-evaluation-2026-9c0804314f160f25.jpg


Qualcomm и Cirrascale обявиха на 17 ноември достъп за оценка на Dragonfly AI200 за избрани клиенти. Платформата е предназначена за AI inference на ниво шкаф. Това е контролиран път за изпитание със собствени натоварвания, а не съобщение за неограничен публичен достъп.

Qualcomm посочва 768 GB LPDDR памет на карта, пряко течно охлаждане, PCIe връзки за разширяване в системата и Ethernet между системи. Cirrascale предоставя управляваната среда. Обещанията за ефективност остават фирмени твърдения; тук няма проведен от SIExpo хардуерен бенчмарк.

Оценката трябва да започне от услугата

Нашият редакционен прочит е, че такъв достъп е полезен, когато клиентът може да запази реалния профил на приложението си. Например интерактивен помощник получава заявки с различна дължина и неравномерни паузи. Еднаква обща скорост на генериране може да скрива различно чакане за отделния човек.

Затова предложеното изпитание трябва да има поне две перспективи: цена на приет резултат и време за обслужване на реалистичната поредица заявки. „Приет“ е важната дума. Ако отговорът е по-евтин, но изисква повече поправки, сравнението на суровите токени няма да опише общата полза. Това е критерий за оценяване, не съобщен резултат за AI200.

Голямата памет също изисква конкретен план. Екипът трябва да провери как се разполагат теглата, работният контекст и едновременните сесии, както и какво остава за обслужващия софтуер. От един общ капацитет не следва автоматично даден брой потребители или максимален контекст за всяка задача.

Софтуерът е част от изпитанието

Връзката на Qualcomm с Cirrascale има и по-стара предистория: партньорски материал от юни 2025 г. описва отделна услуга с Cloud AI 100 Ultra. Този стар продукт не бива да се използва като доказателство за характеристиките на новата AI200 конфигурация.

За приложение, което се премества към друга архитектура, бихме проверили дали нужните оператори, моделни варианти и инструменти за наблюдение са действително поддържани. После бихме сравнили разходите при нормално и при пиково натоварване. Не сме изпълнявали такава миграция и не представяме примерния план като инструкции, гарантирани от доставчика.

Новината е значима с това, че обещанието за специализиран inference получава път към клиентска проверка. Следващата убедителна стъпка са възпроизводими данни за конкретен модел и работен режим. Дотогава най-точният прочит е достъп за избрани изпитания, при който софтуерната съвместимост и качеството на услугата са толкова важни, колкото паметта на картата.

Източници
Qualcomm — Dragonfly AI200 and Cirrascale — 2026-11-17
Cirrascale — earlier Qualcomm inference collaboration — 2025-06-12

Статия в SIExpo.bg: https://siexpo.bg/article/qualcomm-dragonfly-ai200-cirrascale-selected-customer-evaluation-2026
 
Проучване на IBM: AI ръководителите виждат резултатите, но рядко контролират целия бюджет

IBM публикува на 17 ноември проучване за правата на AI ръководителите. Само 18% от анкетираните казват, че имат пълен контрол върху инвестиционните решения за технологията.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

ibm-caio-survey-investment-authority-measurable-outcomes-2026-3539ef3cca5fe9ae.jpg


IBM публикува на 17 ноември проучване за правата на AI ръководителите. Само 18% от анкетираните казват, че имат пълен контрол върху инвестиционните решения за технологията.

Анкетата с Oxford Economics включва 1667 ръководители от 33 географии и 20 отрасъла, допитани през април–юни 2026 г. Обхванати са различни AI длъжности.

Какво показва сравнението

Групата с по-силни отчетени резултати съобщава измерим ефект при 63% от проектите срещу 43% при останалите. Самоотчетите и аналитичното групиране не доказват причината за разликата.

Полезното наблюдение е разминаването между отговорност и власт за решение. Човек може да носи отговорност за показателите, но бюджетът, организацията на работата и окончателното спиране на проект да зависят от други участници. Проучването поставя именно тази връзка под въпрос.

От табло с показатели към действие

Нашият редакционен прочит е, че измерването има стойност, когато предварително е ясно какво следва от него. В примерен проект за обработка на документи екипът може да следи коректност, време за човешка проверка и цена на приет резултат. Ако скоростта се подобрява, но проверката отнема повече време, общата полза може да е различна от показаното в демото.

Това е илюстративен сценарий, а не клиентски случай от анкетата. В него прагът за промяна трябва да бъде определен преди резултатите: кой може да намали обхвата, да поиска допълнителна проверка или да прекрати изпитанието? Без такова решение отчетът остава описание на проблема.

Друг полезен контрол е да се отделя качеството на модела от качеството на внедряването. Дори правилен отговор може да стига до погрешен работен поток. Обратно, добре организиран процес може да ограничи последиците от предвидима грешка. Нито една от двете оценки не замества другата.

Проучването не дава универсална рецепта за прехвърляне на бюджета към една длъжност. То дава повод организациите да направят видими правата за действие около AI. По-съдържателният следващ въпрос е не само „колко проекта имаме“, а „кой може да промени решенията, когато доказателствата се променят“. Именно там данните от таблото могат да станат управленски инструмент.

Източници
IBM — Chief AI Officer study — 2026-11-17
IBM IBV — study landing page

Статия в SIExpo.bg: https://siexpo.bg/article/ibm-caio-survey-investment-authority-measurable-outcomes-2026
 
TokenEconomizer използва историята на проекта, за да намалява повторната работа на AI агенти

Microsoft Research представи на 16 ноември TokenEconomizer — външен контролер за разходите на програмни AI агенти. Той използва предишни сесии в един проект, вместо всяка следваща задача да започва без натрупания работен контекст. Основното изследване е от октомври; новият повод е подробният технически разбор.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

tokeneconomizer-repository-history-agent-cost-control-study-2026-7592b2d689c1a293.jpg


Microsoft Research представи на 16 ноември TokenEconomizer — външен контролер за разходите на програмни AI агенти. Той използва предишни сесии в един проект, вместо всяка следваща задача да започва без натрупания работен контекст. Основното изследване е от октомври; новият повод е подробният технически разбор.

Публикацията и публичното хранилище описват работа без промяна на основния модел. Решението не е автоматично намаление на цената на всеки токен. То се опитва да намали ненужната работа, която агентът извършва и заплаща.

Три различни намеси

Контролерът извлича кратки знания за проекта, ограничава зареждането на неизползвани инструменти и реагира при повтарящи се неуспешни опити. Хранилището уточнява важна граница: ако след насочване агентът още е блокирал, отвореният плъгин уведомява разработчика, вместо сам да прекратява задачата.

Авторите съобщават средно намаление на разходите с 18,4–30,9% при 277 задачи за поправка на дефекти от шест хранилища и пет комбинации агент–модел. Това са техни измервания, не изпитание на SIExpo. Резултатът зависи от поредицата задачи и не обещава същия процент за всеки проект.

Описаният плъгин пази наученото локално и няма нужда от собствен API ключ. Това не превръща извикванията на основния агент в безплатни. Също така не доказва, че всеки лог е безопасен за дългосрочно съхранение: съдържанието му зависи от реалната работа на екипа.

Кога подобна памет е полезна

Нашият редакционен извод е, че най-смислената единица за сравнение е поредица от задачи в един и същ проект. Ако агентът за първи път научава структурата му, помощният контролер може да добави разход. Ползата се търси в следващите сесии, когато същите факти иначе биха били откривани отново.

За собствено изпитание екипът може предварително да избере еднакви критерии за успешна поправка и да записва общата цена, включително помощните заявки. След това да сравни дали намалението идва от по-малко излишни действия или от пропускане на необходимите проверки. Това е предложен метод, а не проведено от нас внедряване.

Полезен пример е знание за командата за тестове. То спестява търсене само докато остава вярно. След промяна на проекта същият запомнен съвет може да започне да пречи. Следователно възможността за оттегляне на остарели бележки е толкова важна, колкото създаването им.

TokenEconomizer насочва вниманието към работния процес около модела. Той предлага проверима хипотеза: натрупаният опит може да направи повторната работа по-икономична. Дали това се случва в конкретен екип трябва да се установи с реални задачи и запазено качество.

Източници
Microsoft Research — repository-aware cost controller — 2026-11-16
Microsoft — TokenEconomizer public repository
TokenEconomizer authors — original preprint — 2026-10-15

Статия в SIExpo.bg: https://siexpo.bg/article/tokeneconomizer-repository-history-agent-cost-control-study-2026
 
AMD приключи придобиването на Taalas: специализираният inference влиза в общата пътна карта

AMD обяви на 17 ноември, че е приключила придобиването на Taalas. Новината следва съобщението от 6 август за окончателно споразумение. Двете дати описват различни етапи: договорената сделка вече е обявена като завършена.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

amd-taalas-acquisition-completed-inference-integration-roadmap-2026-1f25aa15fed38d7f.jpg


AMD обяви на 17 ноември, че е приключила придобиването на Taalas. Новината следва съобщението от 6 август за окончателно споразумение. Двете дати описват различни етапи: договорената сделка вече е обявена като завършена.

Taalas разработва специализиран силиций за AI inference — изпълнението на вече обучени модели. AMD планира да включи технологията в пътната си карта за ускорители и системи. Съобщението не представя нов готов продукт с потвърден срок за доставка.

Какво се събира под една организация

В августовското съобщение Taalas е описана като основана през 2023 г. компания от Торонто. Подходът ѝ е насочен към организацията на потоците от данни при изпълнение на модели. AMD поставя технологията до собствените си Instinct ускорители, EPYC процесори, ROCm софтуер и Helios системи.

Това е заявено намерение за допълване на портфолиото. То не означава, че всички тези компоненти вече работят като един проверен продукт. Настоящото съобщение потвърждава корпоративния етап и разширяването на инженерната дейност в Канада; техническата интеграция остава отделна работа.

Специализацията променя въпросите към хардуера

Нашият редакционен прочит е, че при inference няма единствен смислен показател. За услуга с кратки интерактивни отговори може да е решаващо времето до първия отговор. За пакетна обработка по-важни могат да бъдат общият капацитет и предвидимостта на разхода. Това са примерни профили на натоварване, а не измервания на Taalas.

По-тясно специализирана система трябва да се оценява и по възможността за промяна. Какво става, когато клиентът смени модела, точността на числата или начина на пакетиране? Как се пренасят инструментите за наблюдение и обслужване? Отговорите изискват документация за конкретната реализация, а не заключение само от архитектурното обещание.

Полезен бъдещ тест би сравнил еднакви заявки при еднакво изискване за качество и време. Изчислителната цена следва да включва и обслужващия софтуер, натоварването и поддръжката. Иначе икономичният ускорител може да изглежда по-изгоден в лабораторна задача, отколкото в реален работен ден.

За клиентите днешното приключване на сделката е сигнал за посоката на AMD, не непосредствена инструкция за миграция. За разработчиците следващите важни доказателства са достъпният софтуерен път, поддържаните модели и възпроизводимите системни резултати. Така придобиването може да бъде оценено по това какво добавя към работещата инфраструктура, а не само по корпоративния му мащаб.

Източници
AMD — completion of Taalas acquisition — 2026-11-17
AMD — prior definitive agreement — 2026-08-06

Статия в SIExpo.bg: https://siexpo.bg/article/amd-taalas-acquisition-completed-inference-integration-roadmap-2026
 
Nemotron for Science добавя химичен набор: обучението и проверката трябва да останат отделни

NVIDIA представи Nemotron for Science на 16 ноември: научни приложения на Nemotron 3.5 Super VL, данни и рецепти за последващо обучение на специализирани агенти. Новият повод е научният пакет и Litmus-Bench v0.2, а не повторна премиера на вече познатия основен модел.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

nemotron-science-litmus02-chemistry-training-evaluation-separation-2026-8aaa6e17a79fe054.jpg


NVIDIA представи Nemotron for Science на 16 ноември: научни приложения на Nemotron 3.5 Super VL, данни и рецепти за последващо обучение на специализирани агенти. Новият повод е научният пакет и Litmus-Bench v0.2, а не повторна премиера на вече познатия основен модел.

Фирменото съобщение поставя акцент върху химията и работата със специализирани изчислителни инструменти. Това е изследователска инфраструктура. Представянето не означава доказано лечение, одобрено лекарство или универсално автономна лаборатория.

Какво съдържа провереният артефакт

Картата на Litmus-Bench v0.2 посочва 47 118 тренировъчни въпроса и 2056 тестови въпроса с кратки отговори. Описани са произходът на данните и употребата им за химично разсъждение и обучение с проверими награди. Публичната страница и README са налични; не сме изтегляли и изпълнявали целия набор.

Сред източниците са ChEMBL, ExpansionRx и Biogen, а някои задачи използват дескриптори от RDKit. Картата показва и различни лицензни обозначения. Затова „отворен набор“ не освобождава използващия екип от проверка на условията и произхода на конкретните записи.

NVIDIA свързва пакета с дообучение на модели и с научни агенти, които извикват външни инструменти. Съобщените приложни резултати са твърдения на компанията и партньорите ѝ. Тук не ги превръщаме в независимо възпроизведени клинични или лабораторни постижения.

Защо разделянето на данните е решаващо

Нашият редакционен извод е, че достъпът до тренировъчни и тестови задачи в един пакет създава полезна възможност и ясна отговорност. Ако екип обучава върху въпросите, с които след това измерва успеха, високият резултат може да показва запомняне. Необходимо е да се документира кое влиза в обучението и кое остава извън него.

За собствено изпитание бихме отделили предварително нови молекули или задачи и бихме запазили неизменни версиите на проверяващите инструменти. Това е предложен контрол, не описание на проведен от SIExpo експеримент. Важно е и да се разграничат правилният числен отговор, правилното използване на инструмент и убедителното словесно обяснение.

Например агент може да стигне до вярна стойност чрез външен калкулатор, но да обясни неправилно химичния смисъл. Обратното също е възможно: смислено обяснение с грешно изчисление. Научната употреба изисква тези грешки да се виждат отделно.

Стойността на новия пакет е в по-достъпната основа за такива проверими процеси. Следващият убедителен резултат би включвал описани данни, ясни критерии и независима проверка на изпълнението. Достъпните модели и набори улесняват тази работа; не заменят самото научно доказателство.

Източници
NVIDIA — Nemotron for Science announcement — 2026-11-16
NVIDIA — Litmus-Bench v0.2 dataset card

Статия в SIExpo.bg: https://siexpo.bg/article/nemotron-science-litmus02-chemistry-training-evaluation-separation-2026
 
Qwen4-Max излезе в редовния API: игровите демонстрации поставят въпроса за проверимия резултат

Qwen4-Max вече е отделен редовен модел в QwenCloud, след предварителната версия от 11 ноември. Официалният журнал отбелязва старта на 16 ноември. Калдата насочи вниманието към игровите демонстрации на Alibaba, а проверената документация описва съчетаване на визуално разбиране, код и професионални инструменти.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

qwen4-max-production-api-game-demo-reviewable-delivery-2026-f33d714112ac07e6.jpg


Qwen4-Max вече е отделен редовен модел в QwenCloud, след предварителната версия от 11 ноември. Официалният журнал отбелязва старта на 16 ноември. Калдата насочи вниманието към игровите демонстрации на Alibaba, а проверената документация описва съчетаване на визуално разбиране, код и професионални инструменти.

Това е съществено развитие спрямо временния preview достъп, който SIExpo вече разгледа. Новината тук е наличността на `qwen4-max` и конкретната му интеграция. Двете имена не бива автоматично да се приемат за взаимозаменяеми в клиентско приложение или абонамент.

Какво реално е описано

Документацията посочва един милион токена контекст, текстов изход и вход с текст, изображения и видео. Поддържат се извикване на функции и структуриран изход. Сред показаните приложения е изграждане на игра с Unreal Engine. Това са демонстрации на разработчика, а не проведен от SIExpo сравнителен тест.

Калдата описва цикъл, в който агентът създава, стартира и променя проект след визуална обратна връзка. Такъв цикъл е по-съдържателен от единична снимка на генериран код. Самата демонстрация обаче не показва как системата се справя с произволен чужд проект, неговите зависимости и всички регресии.

Официалните бележки разграничават обикновения API от Token Plan. Достъпът и крайните адреси зависят от региона. Посочен е и важен предел: управляваното дообучение и внедряване на този модел не се поддържат. Приложението следователно трябва да бъде проектирано около действително предлагания облачен интерфейс.

Защо работещата игра изисква критерии

Нашият редакционен прочит е, че агентната разработка трябва да се оценява чрез възпроизводим резултат. Например малък игрови прототип може предварително да има условия: проектът се отваря на чиста машина, контролите работят, нивото може да бъде завършено, а промените не повреждат записаното състояние. Това е предложен начин за приемане, а не тест, който сме изпълнили върху Qwen.

Полезно е да се пазят и междинните версии. Красивата последна сцена не обяснява кои дефекти са били поправени и какво е било загубено при следващата редакция. Когато човекът получава работещ етап, той може да промени посоката навреме, вместо да оценява само крайно видео.

Същата логика важи за документите: отварянето на файл, проверката на формули и проследяването на източниците са отделни действия от убедителното описание в чат. Новият модел разширява набора от инструменти, но критерият за успешно предаване остава конкретната задача.

Практическият извод от старта е ясен: Qwen4-Max вече може да се включи в планирано API изпитание. Екипите трябва да сравняват същата регионална конфигурация, разрешения и набор от задачи. От демонстрирания потенциал до надежден производствен процес има проверима работа, която принадлежи и на разработчика на приложението.

Източници
QwenCloud — model release changelog — 2026-11-16
QwenCloud — current Qwen4-Max specifications
Калдата — Qwen4-Max game demonstrations — 2026-11-17

Статия в SIExpo.bg: https://siexpo.bg/article/qwen4-max-production-api-game-demo-reviewable-delivery-2026
 

Горе