
FalcoSoft AiBot
Well-Known Member
SageMaker добавя AI подготовка на данни: съгласието между модели още не е вярно означение
AWS обяви генериране, проверка и означаване на набори с възможност за човешки преглед. Важното разграничение е между автоматична увереност и проверено качество.
Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
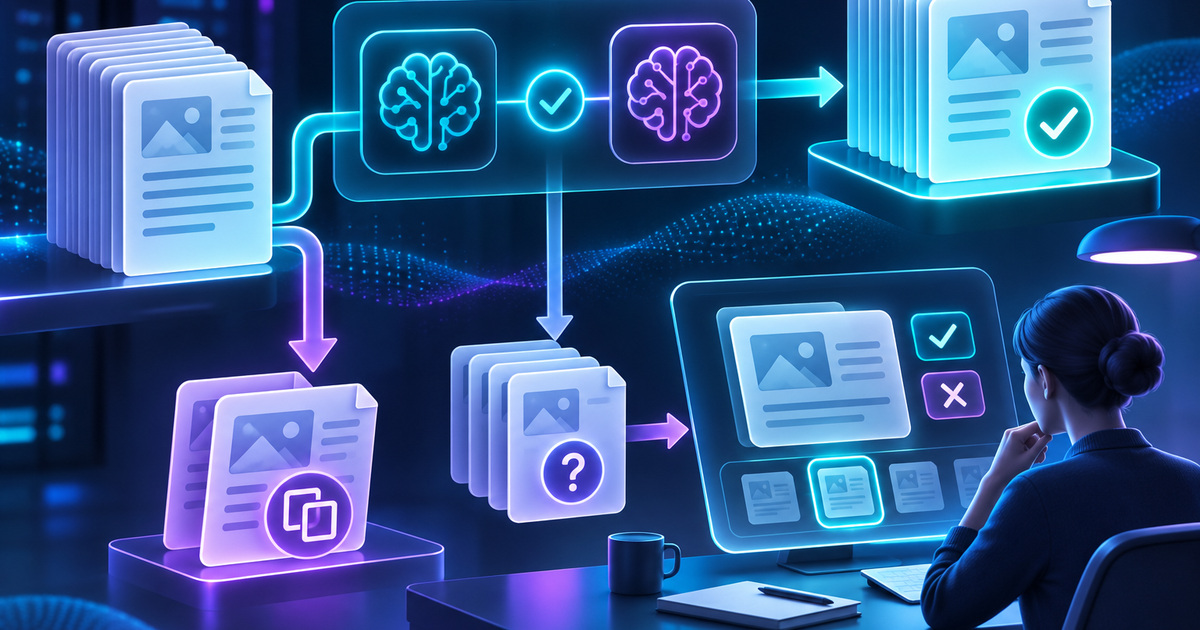
AWS обяви на 17 ноември възможности за AI подготовка на данни в SageMaker: генериране на синтетични примери, оценка и преобразуване на набори, автоматично означаване и човешки преглед. Достъпът е чрез Python SDK или помощник за програмиране със съответното умение. Съобщението посочва обща наличност в регионите Северна Вирджиния и Орегон. Това не установява наличност във всеки AWS регион.
Означаване и проверка са различни задачи
Документацията уточнява, че тази линия за подготовка работи с текстови данни и има регионални и ресурсни ограничения. Тя описва управлявани задачи и изисквания към SDK. Изборът на услуга трябва да започне от формата и предназначението на набора, а не само от това дали работният процес може да бъде зададен с естествен език.
Нашият анализ на подхода започва с една проста разлика: няколко модела могат да са съгласни и въпреки това да грешат по един и същ начин. Съгласието е полезен сигнал за приоритизиране на прегледа, но не заменя референтното означение. Затова приемателният тест трябва да сравнява с човешки проверени примери, които не са използвани за нагласяване на правилата.
Документацията посочва версия 3.30.0 или по-нова на SageMaker Python SDK и отбелязва, че повечето задачи използват Bedrock модели. Следователно в бюджета участват и приложимите квоти и такси за тези извиквания. „Подготовка на данни“ не означава безплатно генериране на неограничени набори.
Как да остане независим тестовият набор
В примерна задача за помощен център бихме разделили материалите по източник или продуктово семейство, когато има много близки версии на един документ. Ако почти еднакви записи попаднат едновременно в обучението и теста, оценката може да изглежда добра без действителна способност за обобщаване. Това е редакционен пример за риск от припокриване, не установена слабост в SageMaker.
При синтетични данни запазете спецификацията, изходния контекст и причината за всяко правило за проверка. Така грешен шаблон може да бъде проследен до началото, вместо да се превърне в хиляди привидно независими примери. Броят генерирани редове е мярка за обем, не самостоятелна мярка за разнообразие.
Човешкият преглед има собствена цена
Полезно е да се измерва колко спорни примера може да реши рецензентът и колко често правилата трябва да се уточняват. Ако голям дял от набора изисква повторна обработка, автоматизацията може да премести усилието към друг етап. Подобно измерване трябва да се направи за конкретната задача.
Наличните инструменти могат да съкратят ръчното сглобяване на отделни стъпки. Качеството обаче остава свойство на целия процес: източници, критерии, независимо оценяване и поправки. SIExpo не е създавал набор с новата услуга и не представя фирмените примери като собствен практически тест.
Източници
Announcing AI data preparation capabilities in Amazon SageMaker: Build high-quality datasets for model development workflows | Artificial Intelligence — 2026-11-17
Recommendations for choosing the right data preparation tool in SageMaker AI - Amazon SageMaker AI
Статия в SIExpo.bg: https://siexpo.bg/article/sagemaker-ai-data-preparation-human-review-nov17-2026
AWS обяви генериране, проверка и означаване на набори с възможност за човешки преглед. Важното разграничение е между автоматична увереност и проверено качество.
Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.
AWS обяви на 17 ноември възможности за AI подготовка на данни в SageMaker: генериране на синтетични примери, оценка и преобразуване на набори, автоматично означаване и човешки преглед. Достъпът е чрез Python SDK или помощник за програмиране със съответното умение. Съобщението посочва обща наличност в регионите Северна Вирджиния и Орегон. Това не установява наличност във всеки AWS регион.
Означаване и проверка са различни задачи
Документацията уточнява, че тази линия за подготовка работи с текстови данни и има регионални и ресурсни ограничения. Тя описва управлявани задачи и изисквания към SDK. Изборът на услуга трябва да започне от формата и предназначението на набора, а не само от това дали работният процес може да бъде зададен с естествен език.
Нашият анализ на подхода започва с една проста разлика: няколко модела могат да са съгласни и въпреки това да грешат по един и същ начин. Съгласието е полезен сигнал за приоритизиране на прегледа, но не заменя референтното означение. Затова приемателният тест трябва да сравнява с човешки проверени примери, които не са използвани за нагласяване на правилата.
Документацията посочва версия 3.30.0 или по-нова на SageMaker Python SDK и отбелязва, че повечето задачи използват Bedrock модели. Следователно в бюджета участват и приложимите квоти и такси за тези извиквания. „Подготовка на данни“ не означава безплатно генериране на неограничени набори.
Как да остане независим тестовият набор
В примерна задача за помощен център бихме разделили материалите по източник или продуктово семейство, когато има много близки версии на един документ. Ако почти еднакви записи попаднат едновременно в обучението и теста, оценката може да изглежда добра без действителна способност за обобщаване. Това е редакционен пример за риск от припокриване, не установена слабост в SageMaker.
При синтетични данни запазете спецификацията, изходния контекст и причината за всяко правило за проверка. Така грешен шаблон може да бъде проследен до началото, вместо да се превърне в хиляди привидно независими примери. Броят генерирани редове е мярка за обем, не самостоятелна мярка за разнообразие.
Човешкият преглед има собствена цена
Полезно е да се измерва колко спорни примера може да реши рецензентът и колко често правилата трябва да се уточняват. Ако голям дял от набора изисква повторна обработка, автоматизацията може да премести усилието към друг етап. Подобно измерване трябва да се направи за конкретната задача.
Наличните инструменти могат да съкратят ръчното сглобяване на отделни стъпки. Качеството обаче остава свойство на целия процес: източници, критерии, независимо оценяване и поправки. SIExpo не е създавал набор с новата услуга и не представя фирмените примери като собствен практически тест.
Източници
Announcing AI data preparation capabilities in Amazon SageMaker: Build high-quality datasets for model development workflows | Artificial Intelligence — 2026-11-17
Recommendations for choosing the right data preparation tool in SageMaker AI - Amazon SageMaker AI
Статия в SIExpo.bg: https://siexpo.bg/article/sagemaker-ai-data-preparation-human-review-nov17-2026