Постоянна тема: Новини за целия AI сектор: модели, програмиране, агенти, роботика, научни изследвания, хардуер и практически приложения.

ето за какво говорим... пресно пресно

Виж файлът 37521
Ами болни хора колкото искаш. За 20 евро някои ще му предложи 100%.
Като е толкова бързо лесно и незначително да вземе да си го направи.

Един беше писал за нещо много сложно и мазало като проект, местене на 3 сървъра на еидния базата на другите 2 app и натоварването да се разпределя и супер много неща беше описал. И един му написал в коментарите ще ти го направя за 200 евро за 2 часа. Имам много години опит. Така ми стана смешно че му писах на тоя че аз имам идентична ситуация и търся кои да ми направи тая работа дали мога да раччитам на него. Каза да същата цена 1-2 часа. Викам му добре имам няколко въпроса преди да започнем:
Знаеш ли какво е load balancer? Каза не аз ще използвам vscode!?
Знаеш ли какво е bastion искам да имам bastion за достъп и другите ми сървъри да нямат външен достъп? Каза ми то с ftp аз ще се свържа!?
Знаеш ли какво е nginx? Как ще направиш връзката между базата данни и 2 та сървъра? Как ще направиш разтоварването между 2 та appa при натоварване? Каза ми то на superhosting ако си има phpmyadmin за лесна работа с базата а сървъра ще ти е в папка!?
WTF предлагаш нещо което ще отнеме 2-3 дена конфигурация и трябва да имаш много опит в някои случай и ai няма да ти помогне. Той ми говори за папки phpmyadmin и щуротии. Представям си как някои си дава достъп до подобни примати да им правят нещо а той с ftp и vscode щял да ги прави..
при фрийлансерите всеки смята, че е факир особенно в ерата на Ai. Ще ти споделя нещо за 10 дни изградих с помощта на Ai 3 банкови сайта +3 финтех оператора с всички екстри в тях дори такива които в сегашните финтех оператори липсват. Въз основа на това направих връзката между тези платформи с по-модерен SWIFT и SEPA енджин по мой модел който надхвърля възможностите на сегашния SWIFT. Най малкото го направих с блокчейн и токенизация , а такава ползват само VISA . Всичко това го направих в екосистема защото съм изклю
чително много в час с банковите системи. На всичко отгоре създадох виртуален АТМ и направих връзка с ПОС терминал който е физически в мен. Такава система мнооого трудно се изгражда защото дори chatGPT не беше в час какво точно се прави и как са навързани системите

1791927910124.webp
 
Прав си, моя грешка! В комюнитито всичко е прекрасно, проблеми няма и никога не е имало. Благодаря ти, че ми отвори очите! 🙏

Позволи ми да продължа с хвалбите — идеите ти са невероятни, всяка една е гениална, критиките ти са безпогрешни, а светът определено има нужда от още повече от тях!

Извинявам се, че за момент си позволих да проявя нещо, наподобяващо собствено мнение. Няма да се повтори! 🙂

*така по-добре ли е?
Еми по-добре е сякаш. :) Никой не те е вързал тук. Не веднъж съм ти го писал.

Явно аз не разбирам защо си го причиняваш, но сигурно има някаква скрита умисъл. Честно казано, не ми пука особено.

Не продължавай с нищо. Достатъчно прочетох.

Дай да спрем със спама и безсмислиците (темата е супер), че после пак "къмюнитито не става". Как да става с такива постове. :)
 
Последно редактирано:
Еми по-добре е сякаш. :) Никой не те е вързал тук. Не веднъж съм ти го писал.

Явно аз не разбирам защо си го причиняваш, но сигурно има някаква скрита умисъл. Честно казано, не ми пука особено.

Не продължавай с нищо. Достатъчно прочетох.

Дай да спрем със спама и безсмислиците (темата е супер), че после пак "къмюнитито не става". Как да става с такива постове. :)

Писах, че е различно и според мен в не добрия смисъл, т.е. имам база за сравнение. "Комюнитито нестава" е твой прочит, защото така, сигурно имаш скрити притеснения. Честно казано, не ми пука особено.

Иначе с менъджерските приоми тип.. като не ти харесва, мое да си одиш.. нема смисъл. Прилагай си ги другаде. Вариантите са два.. или игнор или ме пъдиш нацяло.

У кой крачол да си го нося, мога и сам да си преценя.
 
Liquid AI представи LFM2.5-24B-A2B за локални агенти: какво означават двата милиарда активни параметри

Моделът от 13 октомври има достъпни тегла и 24 милиарда общи параметри. Разглеждаме разликата между изчислителна ефективност, памет, поверителност и лиценз.

Материал на SIExpo.bg, подготвен с помощта на AI. Корица: AI редакционна илюстрация, не документална снимка.

liquid-lfm25-local-agents-october-2026-c04166a3c57a686c.jpg


На 13 октомври Liquid AI пусна LFM2.5-24B-A2B — модел за разсъждение с 24 милиарда общи и около два милиарда активни параметри на токен. Теглата са достъпни за изтегляне. Новината засяга разработчици, които искат агентът им да работи на собствен хардуер, вместо всяко извикване на модела да зависи от отдалечена услуга.

Защо „активни“ не означава размер на файла

Разреждането на изчислението и съхраняването на модела са различни разходи. В архитектура с избираеми експерти за отделния токен се използва част от наличните параметри. Това само по себе си не прави целия набор тегла малък. Купувач на компютър не трябва да изведе нужната памет само от числото A2B в името.

За практически избор са нужни отделни проверки на теглата, работната памет, контекста и едновременните заявки. Дълъг разговор може да има различна цена от кратък въпрос при същия модел. Нашият инженерен прочит е, че „работи локално“ трябва да се доказва с конкретна конфигурация и задача, а не с една цифра за параметрите.

Обявената скорост и границите на сравнението

Liquid AI отчита 184 изходни токена в секунда върху Apple M5 Max и контекст до 131 072 токена. Компанията описва по-добри резултати при част от агентните тестове, но по-слаби при други задачи. Тя съобщава и затягане на оценъчните среди след нежелано поведение по време на обучението. Това са фирмени измервания и обяснения, не независимо потвърдена универсална скорост.

Полезен собствен тест би сравнил еднакви инструкции, инструменти и критерии за приключване. Ако единият агент отговори бързо, но изисква три поправки, първото време до токен не описва целия процес. За приложение значение имат и времето до проверен резултат, отказите и разходът на машината при продължителна работа.

Как се свързва локален агент

Официалното ръководство описва сървър с OpenAI-съвместим интерфейс и отделна агентна среда, която се свързва към него. Извикването на инструменти изисква правилната конфигурация. Ръководството изрично разглежда по-големия модел като възможност с по-висока нужда от памет. Наличието на модел и наличието на работещ цикъл за изпълнение са отделни стъпки.

Представете си помощник за подреждане на вътрешни документи. Моделът може да е локален, но инструментът му да изпраща съдържание към външна търсачка. Поверителността тогава зависи от маршрута на всяко действие. Това е наш пример, не установен проблем с LFM: проверяват се разрешенията, външните услуги и журналът на резултатите.

Какво позволява лицензът

Страницата на модела сочи LFM Open License 1.0. Публикуваният лиценз поставя праг от 10 милиона долара годишен приход за свободната търговска употреба и изисква запазване на лицензионните уведомления при разпространение. Следователно достъпните тегла не означават безусловен Apache 2.0 лиценз. Конкретната употреба трябва да бъде съпоставена с пълните условия.

За малък екип основният въпрос е дали контролът върху средата оправдава настройването и поддръжката. За по-голяма организация се добавя и проверка на лицензионния обхват. Новият модел разширява възможностите за собствена инфраструктура; той не премахва нуждата от реална оценка на паметта, качеството и достъпа до данните.

Предлагаме оценката да започне с ограничена задача и примерни документи с известен правилен резултат. Екипът записва кои файлове са прочетени, какви действия са предложени и дали е поискано одобрение преди промяна. Запазеният отговор е по-слабо доказателство от повторяемо изпълнение с прегледана история на действията.

Източниците са прочетени на 14 октомври 2026 г. между 09:25 и 09:35 ч. по Europe/Sofia. Оценките и примерните проверки са редакционен анализ; SIExpo не е провеждал собствен тест на продукта. Корицата е AI илюстрация, а не снимка на действително събитие.

Източници
Liquid AI — LFM2.5-24B-A2B announcement — 2026-10-13
Liquid AI — local agent guide
LiquidAI model card on Hugging Face
Liquid AI — LFM Open License

Статия в SIExpo.bg: https://siexpo.bg/article/liquid-lfm25-local-agents-october-2026
 
Physical Intelligence отвори Pi API beta: обучение на робот чрез собствените му демонстрации

Съобщението от 13 октомври описва управлявана инфраструктура за адаптиране на модели. Достъпът е поетапен, а облачното изпълнение поставя конкретни въпроси за свързаността.

Материал на SIExpo.bg, подготвен с помощта на AI. Корица: AI редакционна илюстрация, не документална снимка.

physical-intelligence-pi-api-beta-2026-fccd55a47cd8afb5.jpg


На 13 октомври Physical Intelligence представи Pi API beta. Екипите качват роботни данни, адаптират модел върху управлявана от компанията инфраструктура и използват обученото поведение чрез хостван интерфейс. Компанията показва партньорски приложения от Япония, Швейцария и САЩ, но посочва и затруднения със свързаността при част от ранните внедрявания.

Какво се променя за екипа

Нашият прочит е, че услугата прехвърля част от задачата за машинното обучение към доставчик, докато физическият процес остава отговорност на разработчика. Подходящите данни, интеграцията с робота и проверката на действието не се заменят с API ключ. За екип без голяма собствена изчислителна инфраструктура това може да промени откъде започва проектът.

Вместо първо да изгражда цялата обучаваща платформа, той би могъл да започне с добре ограничена задача и показани примери. Важното е демонстрациите да представят реалния обхват: различно разположение на предмети, допустимите отклонения и ситуациите, в които роботът трябва да спре. Тук описваме предложен подход, а не резултат от наш тест на Pi API.

Демонстрация и работеща услуга

В официалния материал Almond е показан с двурък робот, обработващ детайли за собствената си конструкция, след четири дни итерации с API. Това е конкретен фирмен пример, не доказателство, че произволна производствена задача се решава за четири дни. Не извеждаме общ процент надеждност или безопасност от подбраните видеа.

Практическата граница би се проверила със сценарии, които не са били използвани при обучение. Например еднакъв на вид детайл може да лежи под друг ъгъл. Ако оценката включва само познатото подреждане, успешният запис е слабо доказателство за поведението при ежедневни промени. Нужни са отделно описани успех, отказ и безопасно прекъсване.

Достъпът още е поетапен

Формата за кандидатстване казва, че приемането започва с малък брой екипи на групи. Тя пита за опит с обучение и физически роботи, наличните данни и критериите за успех. Това е заявка за beta достъп, а не моментална публична регистрация с гарантиран капацитет. SIExpo не е подавал кандидатура и не разполага с потвърден достъп.

Публичното хранилище openpi дава контекст за предишни модели и експертни версии. Документацията предупреждава, че определени обучени версии може да не работят върху друга роботна конфигурация. Това не е описание на всички нови API модели, но напомня защо съвместимостта се проверява върху конкретното устройство.

Облачният модел и локалната защита

При мрежово зависим процес нашият предложен тест включва забавена или прекъсната връзка. Промяната трябва да бъде наблюдавана в контролирана среда: как се спира движението, как се възстановява задачата и кой разрешава продължаването. Не бива надеждността на защитната функция да се предполага от качеството на модела.

Икономическият въпрос също е за целия процес. Подготовката на данни, интеграцията, проверките и бъдещите промени имат значение наред с цената на услугата. Новата beta е стъпка към по-достъпно адаптиране на роботни модели. Тя не доказва, че хардуерът, инфраструктурата и безопасността са станали универсално решен проблем.

Полезният запис на проекта би запазвал версията на модела, данните за обучение и условията на всяка оценка. При промяна в поведението това помага да се различи нов модел от сменена камера, инструмент или задача. Това е наша организационна препоръка, не обещание, че beta вече предлага всички такива одитни функции.

Източниците са прочетени на 14 октомври 2026 г. между 09:25 и 09:35 ч. по Europe/Sofia. Оценките и примерните проверки са редакционен анализ; SIExpo не е провеждал собствен тест на продукта. Корицата е AI илюстрация, а не снимка на действително събитие.

Източници
Physical Intelligence — Pi API beta announcement — 2026-10-13
Physical Intelligence — API waitlist
Physical Intelligence — openpi documentation

Статия в SIExpo.bg: https://siexpo.bg/article/physical-intelligence-pi-api-beta-2026
 
American Express предложи Intent Intelligence: покупката на AI агент да остане в границите на разрешеното

Рамката от 13 октомври свързва потвърденото намерение с платежната операция. Това е предложение за контрол и интеграция, а не доказан универсален стандарт.

Материал на SIExpo.bg, подготвен с помощта на AI. Корица: AI редакционна илюстрация, не документална снимка.

amex-intent-intelligence-agent-commerce-2026-09b9a94d3f2aeba9.jpg


На 13 октомври American Express публикува Intent Intelligence: потвърденото намерение на клиента да стига до издателя на картата преди покупката на AI агент. Публичната рамка не е доказателство за общоприет стандарт във всички платежни мрежи.

От разговор към разрешена операция

Описани са потвърждение, Intent ID и Proof of Intent Token, ограничен платежен идентификатор и последващи проверки. Интеграциите на ACE Developer Kit още се разработват.

Това разграничение има практическа стойност. Способността на модел да намери подходящ продукт не отговаря на въпроса дали клиентът е разрешил точно тази операция. Разговорът съдържа предпочитания, колебания и примери; платежният контрол трябва да знае кое е окончателно одобрено. Нашият прочит е, че тази граница трябва да бъде видима за потребителя, преди агентът да действа.

Какво носи доказателството за намерение

Техническият материал на Amex описва токена като JWT с основни ограничения. Намерението може да има максимална сума, срок, търговец и брой операции; предвидени са промяна и отказ. Документът предлага от споделяното обобщение да се премахват лични подробности, които не са нужни за покупката. Това са описани проектни правила, не измерени резултати за намалени спорове.

Един хипотетичен пример е поръчка на офис консумативи до определен общ бюджет. Ако агентът избере по-евтин продукт, но добави абонамент, самата ниска първоначална цена не доказва съответствие с задачата. Примерът е наш: полезното разрешение трябва да отразява съществените условия, а екранът за потвърждение да ги показва разбираемо.

Защо подписаните данни не решават всичко

Подписът може да помогне да се установи произходът и целостта на съобщението. Той не доказва, че първоначално описаната покупка е правилно разбрана. Ако потребителят е потвърдил неясно обобщение, добре защитеното предаване ще запази същата неяснота. Затова оценката на интерфейса и оценката на платежната проверка са отделни задачи.

В предложен от нас тест агентът първо показва точната сума, броя покупки и срока. После се проверяват промяна на условията, изтекло разрешение и повторен опит след прекъснат отговор. Системата трябва да може да установи дали операцията вече е извършена, преди да я повтаря. Това са критерии за оценка, а не твърдение, че сме изпълнили интеграция с Amex.

Контрол и достъп до информацията

Потребителят би трябвало да вижда активните разрешения и резултата от тях. Операторът има нужда от достатъчно данни за проверка, без целият личен разговор да се превръща в платежен журнал. При различни участници полезно е да е ясно кой държи актуалното намерение и кой прилага промяната или отказа.

Публикуването на рамката е конкретна новина за посоката на агентните плащания. За успешна реализация остават въпросите за съвместимост, покритие на условията и реално поведение при грешка. SIExpo не твърди, че споровете изчезват, че всички търговци вече поддържат подхода или че технологията гарантира правилно избран продукт.

Същата разлика важи при бъдещи демонстрации: завършеното плащане доказва един път на изпълнение. То не установява какво става, когато агентът промени плана или клиентът оттегли разрешението. Тези гранични случаи трябва да имат ясни резултати, преди услугата да бъде определена като надеждна.

Източниците са прочетени на 14 октомври 2026 г. между 09:25 и 09:35 ч. по Europe/Sofia. Оценките и примерните проверки са редакционен анализ; SIExpo не е провеждал собствен тест на продукта. Корицата е AI илюстрация, а не снимка на действително събитие.

Източници
American Express — Intent Intelligence announcement — 2026-10-13
American Express Technology — Intent Intelligence design — 2026-10-13

Статия в SIExpo.bg: https://siexpo.bg/article/amex-intent-intelligence-agent-commerce-2026
 
Gemini 4 Argon излиза към повече потребители: големият контекст и достъпът имат отделни ограничения

Google обяви глобално внедряване на 13 октомври. Проверихме моделната карта и API документацията; те не подкрепят обещание за безгрешна автономна работа.

Материал на SIExpo.bg, подготвен с помощта на AI. Корица: AI редакционна илюстрация, не документална снимка.

gemini-4-argon-global-rollout-limits-2026-39b6635082fa8374.jpg


На 13 октомври Google обяви глобална наличност на Gemini 4 Argon през API за разработчици и предприятия и посочени потребителски канали. Това е разширяване на достъпа, а не новина, че всеки безплатен профил получава модела. Компанията представя Argon за сложна професионална работа; SIExpo не е измервал неговото качество самостоятелно.

Какво приема моделът

Моделната карта описва текст, изображения, аудио и видео като вход и текстов изход, с общ входно-изходен контекст до един милион токена. Посочени са възможни неточни отговори, забавяне и прекъсвания. Границата на знанията е март 2026 г., а в отделни области те може да са по-стари. Големият капацитет не установява актуалност на конкретен отговор.

Нашият практичен прочит е, че приемането на много информация и използването ѝ правилно трябва да се оценяват отделно. Ако екип изпрати архив с документи, моделът може да получи противоречиви версии. Полезният резултат би показал на коя версия се опира и би отбелязал непотвърдените подробности. Самото събиране на архива в един прозорец не решава този въпрос.

Какво е сигурно за достъпа и цената

API документацията посочва въвеждащи цени до 30 ноември: 2 долара за милион входни и 10 долара за милион изходни токена, включително разсъждението. От 1 декември са посочени 4 и 20 долара. Това са публикувани API тарифи към проверката, не обещание за еднаква цена във всяко приложение или интеграция.

Има и неяснота в плановете. Съобщението споменава Pro и Ultra за приложението Gemini и AI Mode; API страницата казва, че Argon не е наличен на Free tier или Google AI Pro. Страниците говорят за различни канали, но не дават тук достатъчно основание да обещаем конкретен достъп на Pro абонат. Той трябва да провери своя канал и текущите условия.

Как да се оценява професионална полезност

Предлагаме малка задача с известен правилен резултат: няколко версии на техническо изискване и ясна промяна между тях. Проверява се дали моделът намира актуалната версия, отличава източника от предположение и запазва изискването при последваща редакция. Това е наш оценъчен пример, не тест, който сме извършили с Argon.

Следващата проверка е на целия процес. Ако отговорът се използва за промяна в приложение, успехът трябва да се потвърди чрез подходящи проверки, а не чрез уверения текст на агента. Важно е също да се виждат неприключилите действия след прекъсване. Високият капацитет на модела не премахва отговорността за разрешенията и крайния резултат.

Как се четат твърденията за безопасност

Картата казва, че не могат да бъдат изключени определени прагове за биологичен, кибер и контролен риск, и описва приложени мерки. Това е собствената оценка на Google. Не я превръщаме нито в доказателство за настъпила вреда, нито в независима гаранция за безопасност.

Новината е за реално обявено разширяване на наличността и публикувана документация. Решението за употреба трябва да отчита канала, текущата цена, проверимостта на отговора и обработката на отказите. Демонстрацията на сложен резултат е начало на оценката; полезната услуга изисква повторяеми резултати в собствените условия.

Записът на версиите на модела и процеса би направил оценката полезна и във времето. При промяна в качеството екипът може да установи дали са сменени моделът, инструментите или входните документи. Такъв журнал е предложена от нас практика, не твърдение за функция във всеки канал на Argon.

Източниците са прочетени на 14 октомври 2026 г. между 09:25 и 09:35 ч. по Europe/Sofia. Оценките и примерните проверки са редакционен анализ; SIExpo не е провеждал собствен тест на продукта. Корицата е AI илюстрация, а не снимка на действително събитие.

Източници
Google — Gemini 4 Argon global access announcement — 2026-10-13
Google DeepMind — Gemini 4 Argon model card — 2026-10-13
Google AI for Developers — latest model API documentation — 2026-10-13

Статия в SIExpo.bg: https://siexpo.bg/article/gemini-4-argon-global-rollout-limits-2026
 
Anthropic уточни контрола върху OSS Scanner: AI докладът стига до поддържащия екип, но още изисква проверка

Услугата стартира на 8 октомври, а правилата са доуточнени на 13 октомври. Бързите автоматични находки са различни от човешки потвърдените уязвимости.

Материал на SIExpo.bg, подготвен с помощта на AI. Корица: AI редакционна илюстрация, не документална снимка.

anthropic-oss-scanner-maintainer-controls-2026-3abe96afdaed72cc.jpg


На 13 октомври Anthropic допълни обясненията за допустимост и получатели на OSS Scanner — доброволна услуга за сканиране на проекти с отворен код. Самата услуга е пусната на 8 октомври. Важната разлика е, че бързите доклади идват от моделите без предварителната човешка проверка на обичайния координиран процес.

Какво означава бързият маршрут

В първоначалното съобщение Anthropic посочва около 29 000 кандидати за уязвимости и приблизително 6 000 ръчно прегледани доклада за предходния период. Кандидатите не са равни на потвърдени уязвимости. Компанията казва, че докладите могат да съдържат възпроизвеждане, обяснение и предложена поправка, но допуска грешки и завишена тежест.

Нашият прочит е, че автоматизацията променя местоположението на проверката. Поддържащият екип получава по-ранен сигнал, но трябва да реши дали той е реален, относим и нов. Това може да бъде полезно за проект с достатъчно капацитет за реакция. За малък претоварен екип количеството само по себе си не е полезна мярка за защита.

Кой получава чувствителния доклад

Правилата описват проверка на поддържащия екип, контакта и обхвата преди изпращане. Сканирането е офлайн. Това са контроли, описани от оператора; няма независим одит.

Официалното хранилище съдържа конфигурацията за включване: адрес на проекта, основен контакт и подготовка на средата. Допълнителният модел на заплахите може да описва допустимия обхват. Регистрацията не е разрешение за изследване на чужди системи и тази статия не публикува практически атаки или непублични находки.

Как да се прецени един доклад

Предлагаме защитен процес в отделна тестова среда с разрешен от проекта код. Първо се установява засегнатата версия и дали описаният път действително е достъпен при поддържаната конфигурация. След това се проверява дали случаят вече е известен. Едва тогава се оценяват приоритетът и предложената промяна.

Например сигналът може да описва операция, която действителните разрешения не позволяват на непознат потребител. Това е наш хипотетичен пример защо контекстът има значение. Обратното също е възможно: кратко описание може да пропусне важна последица. И в двата случая отговорът е проверка, а не автоматично приемане или отхвърляне заради AI произхода.

Непроверените находки нямат наложен 90-дневен срок за разкриване. След човешко потвърждение се прилага отделният координиран процес. Затова автоматичното съобщение не трябва да се представя като официално установена уязвимост.

Какво да се измерва

Нашият предложен журнал отделя получени, възпроизведени, дублирани, отхвърлени и поправени случаи. Времето до годна поправка е по-полезно от броя изпратени писма. След поправката се проверява и нормалната функционалност, за да не остане проектът с друга грешка вследствие на прибързана промяна.

Новото уточнение прави отговорността и маршрута по-ясни. То не доказва универсална точност на скенера. SIExpo потвърди публичните правила и историята им; не е използвал услугата, не е проверявал чужди уязвимости и не представя фирмените резултати като собствен одит.

Смисленият преглед би запазвал и причината за приемане или отхвърляне на случая. Тя помага при следващи доклади за същия код и намалява повтарянето на работа. Записът трябва да пази достатъчно доказателства за разрешения екип, без чувствителните подробности да стават неограничено публични.

Източниците са прочетени на 14 октомври 2026 г. между 09:25 и 09:35 ч. по Europe/Sofia. Оценките и примерните проверки са редакционен анализ; SIExpo не е провеждал собствен тест на продукта. Корицата е AI илюстрация, а не снимка на действително събитие.

Източници
Anthropic — OSS Scanner FAQ and changelog — 2026-10-13
Anthropic — original launch announcement — 2026-10-08
Anthropic — OSS Scanner configuration repository

Статия в SIExpo.bg: https://siexpo.bg/article/anthropic-oss-scanner-maintainer-controls-2026
 
Служител на OpenAI е обвинен за тайно записващо устройство: фактите и неизвестните

OpenAI заявява, че няма индикации за извличане на тегла, код или клиентски данни. Подреждаме хронологията и разграничаваме фирмената позиция, обвиненията и ролята на AI.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

openai-recording-device-investigation-october-2026-e67e718da1c6fdfb.jpg


Служителят на OpenAI Абдулрахман Алфозан е обвинен в незаконно прихващане или опит за прихващане на устни комуникации. Виновността предстои да бъде установена.

Хронологията според DOJ

- Около 28 септември: предполагаемо поставяне на устройството.
- 30 септември: откриване от персонала.
- 5 октомври: видеозапис на посещение в залата и откриване на второ устройство в оставена чанта.
- 9 октомври: арест.
- 13 октомври: публично съобщение и първо явяване във федерален съд.

Датите подреждат различни събития. Откриване, вътрешна проверка, арест и публично оповестяване не са едно действие. Ето защо тази история не трябва да се описва като устройство, намерено на датата на съобщението. Посочената последователност също не заменя съдебното разглеждане на доказателствата.

Какво заявява OpenAI

В проверената публикация на OpenAI Newsroom компанията казва, че моделите ѝ са помогнали да разбере устройството и произхода му и да идентифицира служител. Тя съобщава за уволнение и съдействие на FBI. Към момента на позицията си заявява липса на индикации за неправомерен достъп или извличане на моделни тегла, изходен код или клиентски данни.

Това е фирмена оценка с времева граница. Не я превръщаме в независимо потвърждение, че никаква информация не е засегната. Разговор, файл и клиентски запис са различни видове информация; оценката за единия не отговаря автоматично на въпроса за останалите. Подобно разграничение е важно, когато кратко заглавие трябва да обобщи сложен инцидент.

AP отбелязва, че обвинителният документ не изяснява какво обвиняемият би искал да направи с евентуално записаните разговори. Следователно крайна цел или външен поръчител не бива да се представят като установени. Същата предпазливост важи за количеството и съдържанието на евентуални записи, които не са проверени от нашата редакция.

Ролята на AI има важна граница

Физическо откриване на предмет, анализ на техническа информация и установяване на отговорност са отделни задачи. Позицията на компанията описва помощ при анализа. Тя не доказва, че модел самостоятелно е забелязал предмета в помещението или е извършил разследването без хора.

Нашият редакционен прочит е, че полезността на AI тук трябва да се оценява чрез проверими стъпки. Каква информация е получила системата, кои нейни изводи са били сверени и кой е взел окончателното решение? Публичното описание не позволява да измерим самостоятелния принос на модела. Затова не представяме случая като демонстрация на универсален AI детектив.

Какво показват изображенията

Съобщението на DOJ съдържа изображения на устройство и кадър от видеонаблюдение. Съпоставихме предоставените ни две изображения с публикуваните приложения. Те се пазят като документални материали, публикувани от DOJ, а не като AI илюстрации. Изображението на обвиняемия не е самостоятелно доказателство за вина.

Корицата на тази статия е отделна AI редакционна илюстрация на защитата на поверителни разговори. Тя не пресъздава действителната зала, устройството или конкретния човек. Разделянето на документ и илюстрация помага на читателя да разбира кое е източник и кое е визуален редакционен избор.

Защо случаят е важен за AI сектора

Според нашия анализ защитата на една лаборатория включва и мястото, където се вземат решения. Дори добре защитена цифрова система не дава пълен отговор на въпросите за достъпа до помещения, срещи и поверителни обсъждания. Това е общ извод за управлението на риска, а не констатация за непубличните системи на OpenAI.

За организациите полезната посока е проследим процес: кой приема сигнал, как се пазят доказателствата, кой проверява резултатите и как се комуникира несигурността. AI помощникът може да е част от такъв процес, но отговорността за проверките остава при хората. Контролът трябва да отчита и личното пространство, вместо да превръща всяко необичайно действие на служител в доказателство за злоупотреба.

Какво следим оттук нататък

Следващите съдебни документи могат да променят разбирането за случая. Ще отделяме новите доказателства от повторени фирмени изявления и ще коригираме материала, ако се изяснят целта, засегнатата информация или ролята на отделните участници. Най-същественият въпрос остава какво може действително да бъде доказано, а не колко убедително звучи една версия.

Източници: DOJ — официално съобщение, OpenAI Newsroom — проверена позиция, AP — независимо отразяване.

Документални приложения: изображения на устройството, публикувани от DOJ, кадър от видеонаблюдение, публикуван от DOJ.

Проверено от редакцията: 2026-10-14T14:51:59.845945+00:00 (UTC).

Източници
DOJ — Saudi National Arrested for Installing Surreptitious Audio Recording Device at OpenAI — 2026-10-13
OpenAI Newsroom — statement on office recording device — 2026-10-13
AP / Eric Tucker — FBI arrests OpenAI employee accused of placing recording device in company conference room — 2026-10-13

Статия в SIExpo.bg: https://siexpo.bg/article/openai-recording-device-investigation-october-2026
 
NEURA представи Neuron AI: роботът да съчетава зрение, допир, звук и памет

Германската компания предлага общ модел за физическо действие. Обявената демонстрация в Берлин предстои; промишлената надеждност още изисква отделни измервания.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

neura-neuron-ai-multisensory-robotics-2026-cb41b5745e8d88a3.jpg


На 14 октомври 2026 г. NEURA Robotics представи Neuron AI в Мецинген. Според компанията моделът съчетава 3D зрение, допир, звук, състоянието на робота, език и памет. Обучението използва роботни данни, симулации и човешки демонстрации; посочени са пет роботни форми. За GTC Berlin на 20–22 октомври е обявена единадесетминутна последователност с пране. Това е предстояща демонстрация, а не независимо проверен производствен резултат.

От изображение към физическо действие

В нашия редакционен прочит същественото е как различните сигнали могат да се проверяват взаимно. Ако машина вижда предмет, това още не означава, че знае дали го държи здраво. Допълнителното измерване на контакт може да промени решението за следващото движение. Това е обяснителен пример, не наблюдавана от нас задача на Neuron AI.

Паметта също трябва да се оценява чрез поведение. Бихме проверили дали роботът може да продължи задача след временно закриване на предмет, да различи старо наблюдение от ново и да спре при противоречиви сигнали. Красивата визуализация на модел не отговаря на тези въпроси. Нужни са повторяеми изпитвания с ясно описани условия и човешки контрол върху границите на действие.

Платформата е отделен слой

Страницата на Neuraverse описва обща платформа за оркестрация, цифрови двойници и приложения. NEURA представя своите Gyms като места за физическо обучение и проверка. Това е контекст от същия доставчик, не независима оценка на новия модел.

Според нашия анализ пренасянето на умение между роботи е и задача по управление на версии. Екипът трябва да знае кой модел, кои данни и коя конфигурация са използвани. Промяна на камера, ръка или работна повърхност може да наложи нова проверка. Една споделена платформа има практическа стойност, когато запазва тази следа и позволява връщане към проверена версия при проблем.

Роботът не е само софтуер

Официалната продуктова страница на 4NE1 посочва сензорно покритие, многомодален AI и дистанционно управление, както и различни конфигурации за отделни среди. Тези характеристики са заявени от производителя. Те не доказват автоматично автономност във всяка задача и не са разрешение машина да работи без оценка на конкретното място.

За предприятие полезният първи тест би бил ограничен процес с известни материали и ясна безопасна зона. Бихме записвали завършените задачи, намесите на оператор и причините за спиране. Времето за обучение и времето за надеждна работа трябва да се разграничават. Ако служител подготвя всяка следваща стъпка, тази помощ принадлежи към описанието на резултата.

Какво остава да се докаже

Не представяме едно фирмено съобщение като общо решение на роботиката. За оценката ще са важни разнообразието на задачите, повторяемостта, поведението при отказ на сензор и възстановяването след грешка. Обявената демонстрация може да даде полезен пример, но сама по себе си не измерва работа през цяла смяна.

Новината показва европейска посока за Physical AI: моделът се разглежда заедно със сетивата, машината и процеса на внедряване. Нашият извод е, че напредъкът ще се оценява по проверими действия и ясни ограничения. Следващото наблюдение трябва да сравни заявеното днес с действително показаното в Берлин, без да превръща бъдещите обещания в сегашни факти.

Източници: NEURA Robotics — Neuron AI, NEURA — Neuraverse ecosystem, NEURA — 4NE1 product context.

Редакционна проверка: 2026-10-14T16:34:39.030582+00:00 (UTC).

Източници
NEURA Robotics — Neuron AI — 2026-10-14
NEURA — Neuraverse ecosystem
NEURA — 4NE1 product context

Статия в SIExpo.bg: https://siexpo.bg/article/neura-neuron-ai-multisensory-robotics-2026
 
Danaher и NVIDIA свързват AI предвижданията с лабораторни измервания

Партньорството започва с избрани научни инструменти. Целта е цикъл между модели и експерименти; ускорени открития или лечебни резултати още не са доказани.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

danaher-nvidia-scientific-instruments-ai-2026-bf95d2076439bacf.jpg


Danaher обяви на 14 октомври 2026 г. сътрудничество с NVIDIA за свързване на научни инструменти, лабораторен софтуер и AI изчисления. Първоначално се работи с избрана група инструменти. Посочени са DGX Spark, RAPIDS и BioNeMo; цифровите двойници са посока за проучване. Заявената цел е експериментите да подобряват моделите, а моделите да насочват следващи експерименти. Съобщението не е доказателство за завършена автономна лаборатория.

Предположение и измерване са различни резултати

Нашият редакционен прочит е, че полезният AI процес трябва да запазва разликата между предложена хипотеза и наблюдаван факт. Компютърният модел може да класира възможни варианти за проверка. Измерването обаче трябва да бъде свързано с действителната проба, условията и използвания инструмент. Ако тези данни липсват, красиво изчислено предвиждане не може да се превърне в лабораторно доказателство.

Един обяснителен сценарий е екип да сравнява няколко предварително избрани кандидата. AI предлага ред за изпитване, операторът допуска безопасните процедури, инструментът записва резултатите, а специалистът оценява отклоненията. Това е наша илюстрация на възможен процес, не описание на вече внедрена система при клиент на Danaher.

Изчислителният слой има конкретна роля

Документацията на NVIDIA за CUDA-X описва GPU библиотеки за обработка на таблици, машинно обучение и графови анализи. Сред тях са cuDF, cuML и cuGraph. Този контекст обяснява вида софтуерни операции; рекламните ускорения от страницата не са измерени резултати за новото партньорство.

Според нашия анализ бързото изчисление е само една част от общото време. Подготовката на пробата, физическият експеримент и проверката на качеството остават отделни стъпки. За оценка бихме сравнили целия процес, включително прехвърлянето на данни и повторените измервания. Съкращаването на една операция не означава същото съкращаване на времето до научно заключение.

Моделът трябва да бъде избран според задачата

Прочетеният обзор на BioNeMo различава средства за обучение и настройване на биомолекулярни модели от услуги за изпълнение на вече подготвени модели. Страницата е обозначена като по-стара документация, затова я използваме за общия принцип, не като списък на актуалните версии или гаранция за съвместимост.

Практическият въпрос, в нашия прочит, е какво трябва да се промени за конкретната научна задача. Понякога е достатъчно да се изпълни готов модел; друг път са нужни нови данни и проверено настройване. Екипът трябва да пази версията, произхода на данните и критериите за приемане. Иначе повторението на експеримента може да използва различен софтуер, без това да е видимо в отчета.

Как ще се оценява обещанието

Научната стойност не е броят автоматично предложени варианти. Бихме търсили възпроизводими измервания, контролни условия и ясно описани неуспешни опити. Полезна система трябва да отчита и кога няма достатъчно основание за следваща стъпка, вместо да произвежда непрекъснато уверени препоръки.

Партньорството е значимо като заявена посока за свързана лабораторна инфраструктура. То още не доказва, че дадена терапия е разработена по-бързо или че човешката научна преценка е заменена. Следващите проверими въпроси са кои инструменти са свързани, какви данни обменят и какви резултати могат да повторят независими екипи. До тогава говорим за сътрудничество и цели, като запазваме експерименталното доказателство в центъра на историята.

Източници: Danaher — collaboration with NVIDIA, NVIDIA — CUDA-X data science, NVIDIA — BioNeMo framework overview.

Редакционна проверка: 2026-10-14T16:34:39.030582+00:00 (UTC).

Източници
Danaher — collaboration with NVIDIA — 2026-10-14
NVIDIA — CUDA-X data science
NVIDIA — BioNeMo framework overview

Статия в SIExpo.bg: https://siexpo.bg/article/danaher-nvidia-scientific-instruments-ai-2026
 
Wharton–GBK: положителната оценка за AI не е същото като измерена промяна в бизнеса

Четвъртото годишно изследване сравнява ръководители и служители. Данните са самооценки от САЩ; връзките между управление и резултат не доказват причинност.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

wharton-gbk-ai-adoption-returns-gap-2026-3a7a2063cc37f411.jpg


Изследването The Adaptive Advantage на Wharton Human-AI Research и GBK Collective, представено на 13 октомври 2026 г., поставя въпроса как се измерва бизнес резултатът от AI. GBK описва 1416 участници: 1007 ръководители и 409 служители на начално или средно ниво. Според авторите 80% от ръководителите отчитат положителна възвръщаемост, но само 7% покриват едновременно трите определени признака за успех. Това са самооценки, не независим финансов одит.

Едно число не описва цялата промяна

В нашия анализ положителната оценка може да означава различни неща. Спестено време за една задача, по-малко повторна работа и нов приход са отделни резултати. Не е полезно да се обединяват в общо впечатление, ако организацията иска да разбере къде инвестицията работи. Първата практическа стъпка е да се уточни какво се сравнява и за какъв период.

Например екип може да използва AI за първи вариант на клиентски отговор. За оценка бихме следили времето до окончателен проверен отговор, броя нужни поправки и удовлетворението на клиента. Това е наш обяснителен сценарий, не измерен проект от проучването. Самото генериране на повече текст не е достатъчно доказателство за по-добра услуга.

Гледната точка на служителите е отделна

Официалното съобщение отчита разлика в оценката за обучението: 78% от ръководителите смятат, че то е достатъчно, срещу 56% от служителите. То посочва и 28% силно положителна възвръщаемост сред ръководителите. Тези данни са от същото изследване и не представляват второ независимо потвърждение.

Нашият прочит е, че обучение не трябва да означава само достъп до интерфейс. Бихме проверили дали човек знае как да разпознае грешка, какви данни може да използва и кога да поиска помощ. Ако служителят прекарва време в поправяне на неясни AI резултати, тази работа трябва да се вижда в оценката. Иначе управленският отчет може да изглежда по-добре от действителния работен ден.

Контролът има цена и цел

Рамката AI RMF на NIST е доброволен подход за управление на AI рискове при проектиране, използване и оценяване. Тя не е сертификат за конкретен продукт и не оценява финансовия резултат в това проучване. Използваме я като отделен контекст за управленската отговорност.

Според нашия анализ проверката трябва да бъде съобразена с последствията от действието. Чернова за вътрешна бележка и промяна на клиентска поръчка не изискват еднаква процедура. Разумният процес описва кой допуска действието, как се записва резултатът и как се поправя грешка. Това позволява да се оценява и цената на контрола, вместо тя да остава скрита зад обещанието за автономност.

Какво можем и не можем да заключим

Връзка между начин на управление и по-добра оценка не доказва, че първото причинява второто. Екипите могат да се различават по задачи, ресурси и готовност. Затова не превръщаме анкетата в универсална рецепта за българско предприятие и не обещаваме възвръщаемост от определена организационна промяна.

Полезният принос е по-точният въпрос: какво е подобрено, кой го е измерил и какво още остава извън отчета? Нашият извод е, че разпространението на AI и успешното му използване трябва да се проследяват поотделно. Следващата стъпка за всяка организация е собствено сравнение с ясни критерии, запазени ограничения и участие на хората, които извършват ежедневната работа.

Източници: GBK — measuring enterprise AI, 2026 study, GBK — fourth Wharton AI study release, NIST — AI Risk Management Framework.

Редакционна проверка: 2026-10-14T16:34:39.030582+00:00 (UTC).

Източници
GBK — measuring enterprise AI, 2026 study — 2026-10-13
GBK — fourth Wharton AI study release — 2026-10-13
NIST — AI Risk Management Framework

Статия в SIExpo.bg: https://siexpo.bg/article/wharton-gbk-ai-adoption-returns-gap-2026
 
LIBERO-RIG проверява как промяната на камерата и настройката обърква AI роботите

Новият препринт тества устойчивостта на роботни политики при промени в оборудването. Резултатите са от симулационен benchmark, а не универсална оценка на реални машини.

Материал на SIExpo.bg. Корица: AI редакционна илюстрация, не документална снимка.

libero-rig-robot-hardware-robustness-2026-43defc107ac5a18e.jpg


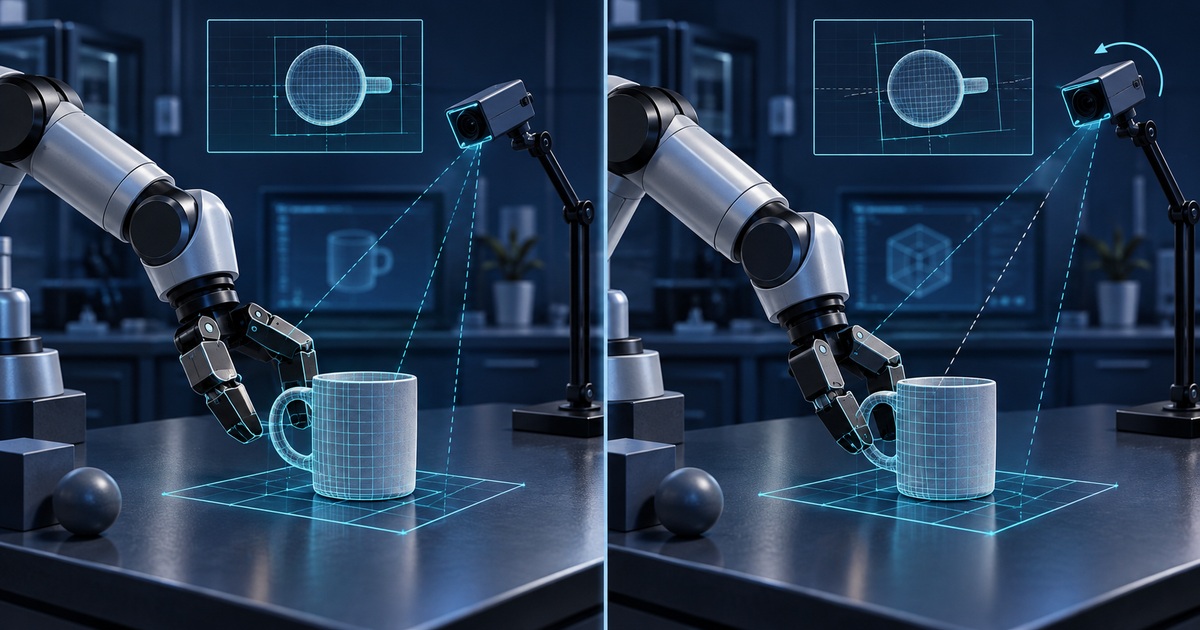
Препринтът LIBERO-RIG, подаден в arXiv на 13 октомври 2026 г., изследва промени в оборудването при запазени роботни задачи. Авторите тестват девет vision-language-action модела по единадесет направления и пет степени на промяна. Отчитат общ успех 0,932 при номинални условия, 0,767 при средна и 0,509 при най-висока тежест. Това са резултати на авторите в симулационна среда; редакцията не е повторила тестовете.

Задачата може да остане същата, средата — не

В нашия редакционен прочит оценката е важна, защото въпросът към робота не винаги се променя, когато се промени оборудването. Чашата може да трябва да бъде преместена на същото място, но камерата вече да гледа от различен ъгъл. Това е обяснителен пример, не допълнителен измерен резултат от препринта.

Полезният тест трябва да показва какво точно е променено. Ако едновременно се сменят предметът, инструкцията и настройката, не е лесно да се установи причината за неуспеха. Бихме запазвали отделни записи за всяка конфигурация и проверявали дали самата задача остава изпълнима. Така общият процент може да се свърже с конкретно ограничение, вместо да се превърне в етикет за целия модел.

Какво означава LIBERO

Оригиналното хранилище на LIBERO описва benchmark за пренос на знания в многозадачно и продължаващо роботно обучение. То предоставя задачи и човешки демонстрации чрез телеоперация, с набори за пространствени отношения, предмети и цели. Това е контекст за основата на новото изследване, не независимо повторение на LIBERO-RIG.

Според нашия анализ общите задачи са полезни за сравнение, когато протоколът е ясно запазен. В същото време мястото в класация трябва да се чете заедно с начина на обучение и изпълнение. Ако различни екипи използват различни настройки, близките резултати не доказват непременно разлика в способностите. За практическа оценка е необходима и проверка на условия, близки до планираното приложение.

По-ранен контекст за ограниченията на benchmark-ите

Отделен препринт от 2 юни, What Are We Actually Benchmarking in Robot Manipulation?, разглежда риск от преки пътища, статистически неубедителни разлики, постепенно пренастройване и зависимост от данните. Авторите предлагат диагностични проверки. Това е различно изследване и не трябва да се смесва с новите числени резултати.

Нашият извод от този контекст е, че добрата оценка изисква повече от висок процент. Тя трябва да обясни коя способност е измерена, кои алтернативни обяснения са проверени и какво не е включено. Повторението на позната задача може да е полезен тест, без автоматично да доказва общо разбиране на непозната среда.

Какво следва за разработчиците

Бихме използвали такъв benchmark като сигнал къде да насочим изпитванията, а не като готово разрешение за внедряване. При реална машина трябва да се оценят конкретните сензори, механика, работна зона и безопасно спиране. Симулационната проверка и изпитването на терен отговарят на различни въпроси.

Новината е полезна именно с промяната на фокуса: AI роботът се оценява заедно с настройката, от която зависи действието му. Нито един от посочените проценти не е универсална вероятност за успех във фабрика или дом. Следващата проверима стъпка е независимо повторение на протокола и ясно сравнение с физически изпитвания, преди резултатът да бъде използван за широки обещания за автономност.

Източници: LIBERO-RIG — original preprint, LIBERO — original benchmark repository, What Are We Actually Benchmarking in Robot Manipulation?.

Редакционна проверка: 2026-10-14T16:34:39.030582+00:00 (UTC).

Източници
LIBERO-RIG — original preprint — 2026-10-13
LIBERO — original benchmark repository
What Are We Actually Benchmarking in Robot Manipulation? — 2026-06-02

Статия в SIExpo.bg: https://siexpo.bg/article/libero-rig-robot-hardware-robustness-2026
 

Горе